Как я один держу ИИ-сервис перевода видео: сервер на одно ядро, GPU за 20 тысяч в месяц и семь чужих нейросетей
Этот текст написан в Сообществе, в нем сохранены авторский стиль и орфография
Я основатель Speeek. Сервис берёт ролик, распознаёт речь, переводит, озвучивает голосом того же человека и собирает видео обратно. За три с половиной года — 227 тысяч пользователей и 92 тысячи готовых переводов. Команда — я один. Выручка есть, инвесторов нет, отдела эксплуатации нет, и спать по ночам, как выяснилось, тоже не всегда получается. Расскажу, во что это обходится, на чём держится и как ломается. Честно: за последний месяц два серьёзных сбоя, оба наши.
О Сообщнике Про
Основатель Speeek.io, перевод видео нейросетями. Делаю сервис один с 2022 года, пишу о голосовых нейросетях и о том, где они ошибаются.
Это новый раздел Журнала, где можно пройти верификацию и вести свой профессиональный блог
Что происходит с минутой видео
Пользователь загружает файл или ссылку на YouTube. Дальше ролик идёт по цепочке, и каждый шаг — отдельная нейросеть, почти всегда чужая:
- голос отделяется от музыки и шума;
- речь распознаётся по словам, с таймкодами и кто говорит;
- слова собираются в предложения (распознавание отдаёт текст без точек — да, в 2026 году);
- из реплик спикера делается клон его голоса;
- текст переводится — языковая модель, пачками по 50 фраз, весь ролик как контекст;
- перевод озвучивается фраза за фразой;
- озвучка укладывается в тайминг оригинала, сводится с фоном и ставится обратно на видео. Липсинк — отдельно, кому надо.
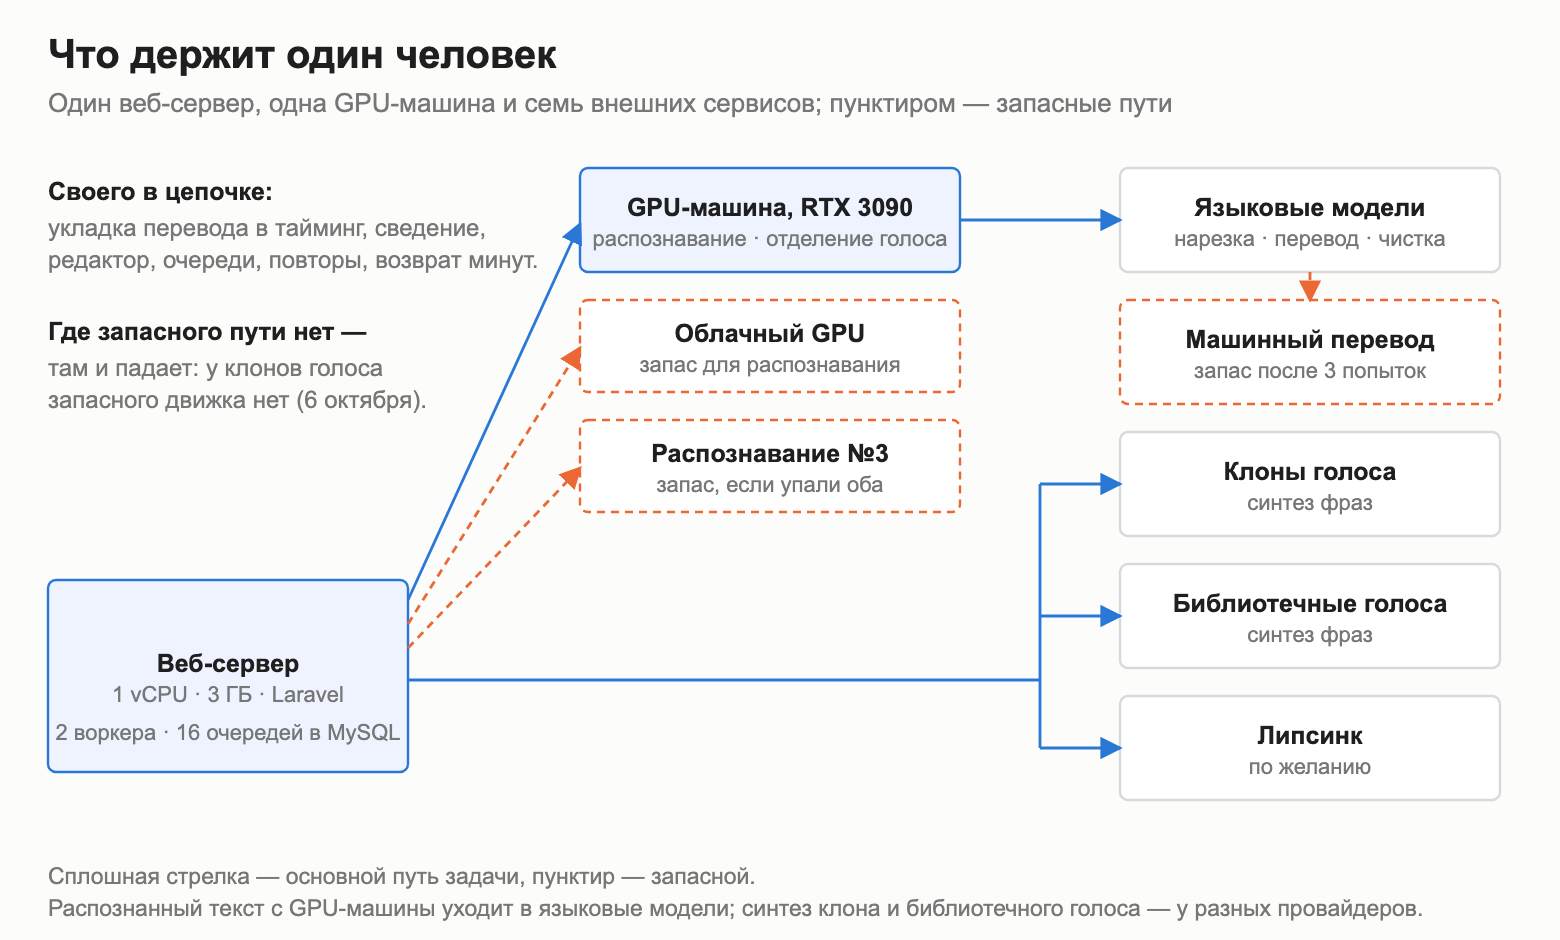
Своего тут — укладка: алгоритм, который втискивает перевод в секунды оригинала, когда русская фраза длиннее английской (а она длиннее всегда, русский язык — он такой). Плюс сведение, редактор, очереди, повторы, возврат минут при ошибке. Сами нейросети — по API. То есть бизнес такой: семь чужих моделей, склеенных так, чтобы клиенту пришёл готовый ролик, а не семь счетов и инструкция.
Сколько стоит железо
Веб-сервер: 1 vCPU, 3 ГБ памяти, диск 99 ГБ, около 3 000 рублей в месяц. Load average в обычный день — 0,01. Когда я называю эти цифры знакомым разработчикам, они переспрашивают про ядро. Да, одно. Нет, не узкое место.
Потому что сервер ничего тяжёлого не делает: качает файл, режет аудио ffmpeg, раскладывает работу по очередям и ждёт. Тяжёлое крутится на отдельной машине с RTX 3090 за 18–20 тысяч в месяц — там распознавание и отделение голоса. Всё остальное у провайдеров, и вот они и есть главная статья расходов. Самое дорогое — синтез голоса и GPU. Самое дешёвое, как ни странно, языковые модели: все вместе меньше 100 долларов за месяц. Про них ниже, там есть чем похвастаться.
А теперь про то, чем хвастаться нечем. Почти три года я платил за сервер около 11 тысяч в месяц, и почти всё это — SSD на 500 ГБ. Зачем? Чтобы готовые переводы лежали «горячими», пока клиент их редактирует. S3 был, но туда уезжали только задачи старше 30 дней. Логика казалась железной. Потом посмотрел в данные: редактируют в первые сутки, а дальше файлы просто лежат и стоят денег. Теперь задача через 24 часа без движения уезжает в S3 архивом, а при первом клике подтягивается обратно. Клиент разницы не видит, сервер дешевле в три с лишним раза. Два с лишним года переплаты за «а вдруг откроют». Откройте свой счёт за хостинг, там наверняка тоже есть такое «а вдруг».
Очереди — два воркера Laravel, 16 очередей по приоритету тарифа (кто платит больше, у того очередь короче). Живут в таблице MySQL, без Redis, и почти всегда пустые. База напомнила о себе за три года один раз: в августе таблица задач доросла до 1,2 ГБ, транскрипция в JSON бывает по мегабайту на строку, и MySQL с настройками по умолчанию выдал «Out of sort memory». Индексы, swap, конфиг — полчаса. Всё.
Семь ключей живых и пять мёртвых
В.env на продакшене семь действующих ключей ИИ-сервисов. И пять мёртвых: ElevenLabs, SaluteSpeech, ещё один движок синтеза, две заброшенные ветки. Удалять рука не поднимается — это кладбище провайдеров и есть история сервиса.
Правило, к которому я пришёл не сразу и не бесплатно: у каждого шага должен быть запасной путь. Распознавание — своя GPU-машина, не ответила вовремя — облачный GPU, не ответил — третий сервис. Перевод — три попытки, потом частичный результат добивается обычным машинным переводчиком. Синтез — повтор с той фразы, на которой упало, а не с начала.
Стреляет ровно там, где запасного пути нет. 6 октября в час ночи провайдер клонов голоса двенадцать минут отвечал ошибкой 500. Запасного движка клонов у меня к тому моменту не было (почему — ниже), и за эти двенадцать минут упали пять переводов у новичков. Новичок, у которого первая задача упала, второй раз не приходит. Я бы тоже не пришёл.
Вечер, когда синтез перестаёт отвечать
Третьего октября я открыл бесплатный тариф с превью первой минуты для всех. Синтезов стало в четыре-пять раз больше, и вылезло то, что раньше тонуло в шуме.
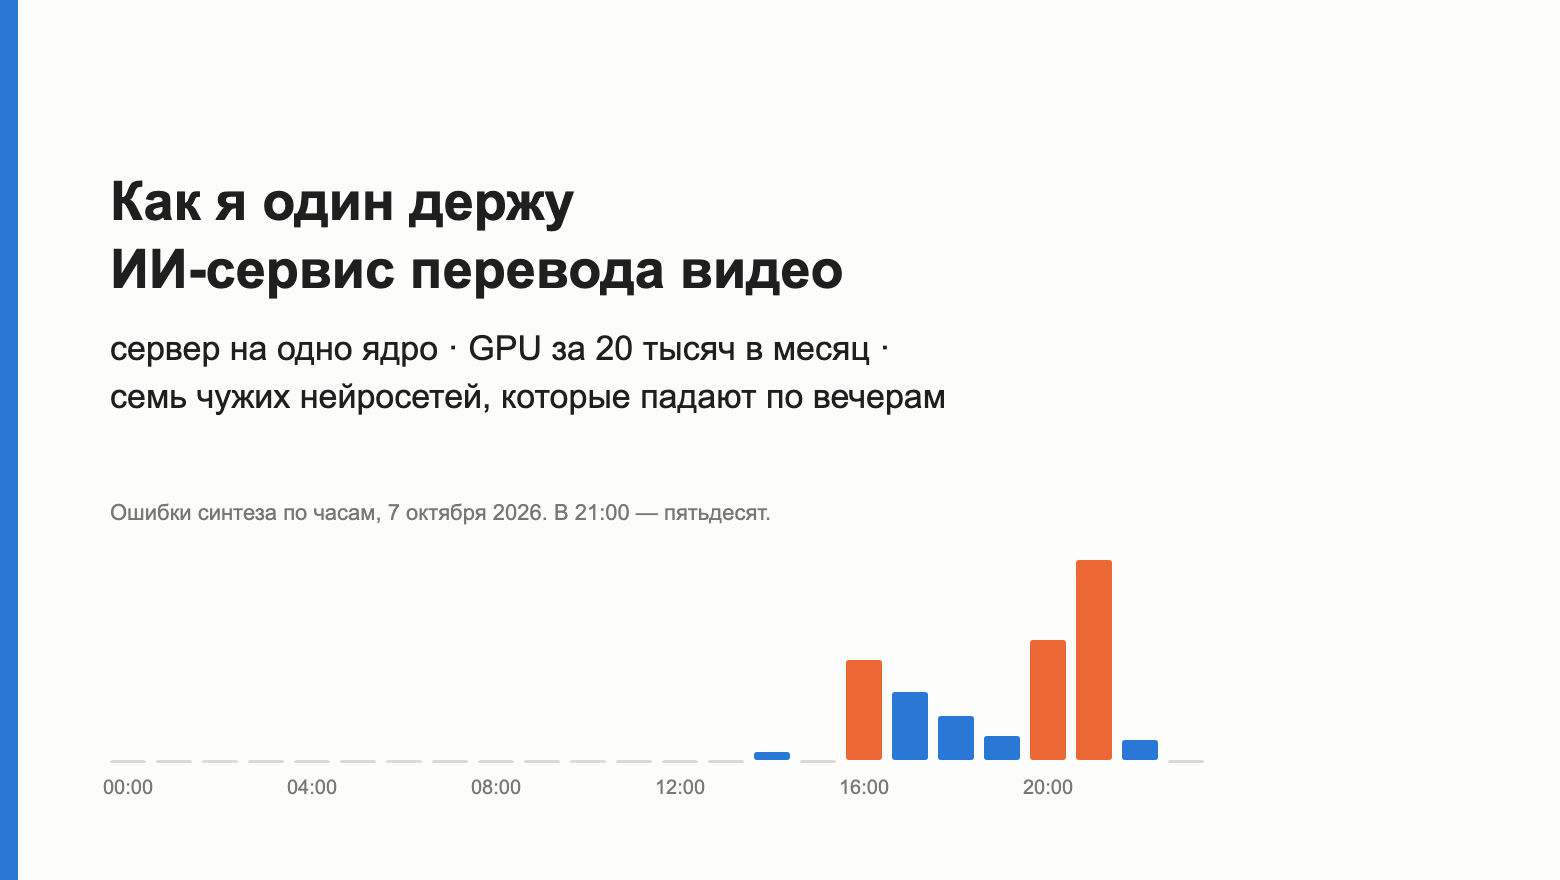
Каждый вечер с семи до двух ночи (у меня UTC+5) синтез библиотечных голосов переставал отвечать. Ошибок в логе по дням: 29, 80, 103, 98. Четырнадцать процентов превью новичков за двое суток закончились «ошибкой синтеза». Четырнадцать процентов людей пришли попробовать и увидели красную плашку. В тот момент, когда я наконец сделал бесплатный вход. Обидно до злости.
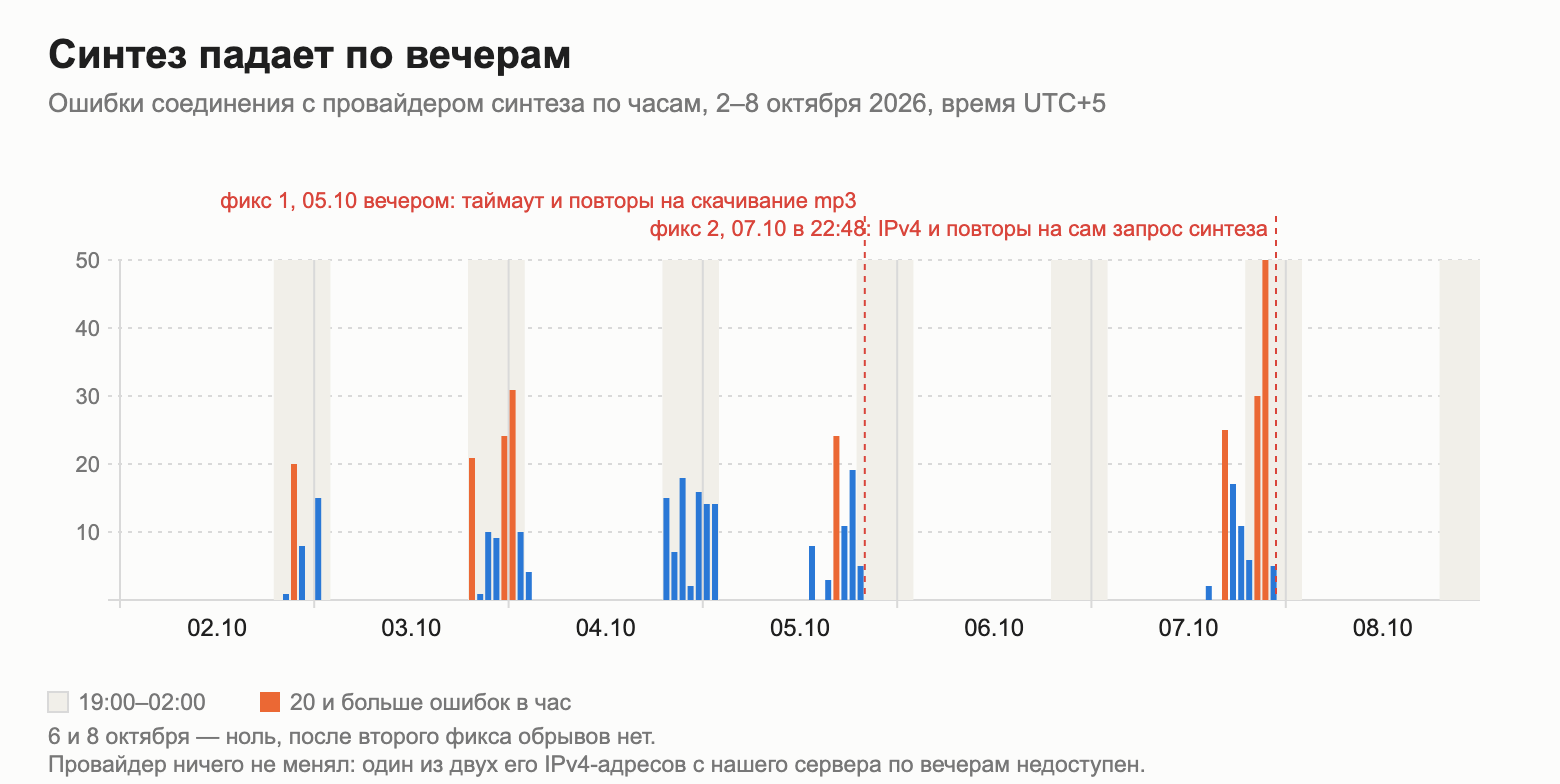
Провайдер ничего не менял. У его хоста два IPv4-адреса, и один из них с нашего сервера по вечерам недоступен — почему, я так и не узнал, и уже не узнаю. PHP-шный file_get_contents без таймаута честно ждал минуту и падал. Пятого вечером поставил таймаут пять секунд и три повтора на скачивание готового mp3 — шестого ошибок ноль, я доволен, иду спать. Седьмого выясняется, что сам запрос на синтез идёт другим путём и повторов у него нет: пятьдесят ошибок за один час. В 22:48 выкатил принудительный IPv4 и четыре повтора. С 23:00 — тишина.
Четыре дня, два фикса по одному файлу. Первый закрывает то, что видно, второй — то, что открыл первый. Так всегда, и я каждый раз на это ведусь.
День, когда ElevenLabs закрыл дверь
23 апреля 2025 года ElevenLabs закрыл наш аккаунт. Одним днём, без письма — просто перестал пускать из России. Клоны голосов всех клиентов жили там. Помню этот вечер хорошо: 25 коммитов, клоны переехали на другой движок, в полночь всё работает. С той же даты умер SaluteSpeech, но его я уже не оплакивал.
Дальше это стало рутиной. За полтора года — шесть движков синтеза. Перевод: сначала DeepL пофразно, без контекста; с августа 2025 — языковая модель пачками по 50 фраз; с сентября 2026 — другая модель и весь ролик как контекст. Отделение голоса пять раз за год переезжало между своей машиной и облачным GPU. Второго октября убрал ещё один движок клонов: он стал требовать запись согласия на каждый клон, а его модель снимают в ноябре. 772 клона клиентов переведены на другой движок и пересоздаются при первом синтезе — клиенты не заметили, и это, пожалуй, единственное, чем я во всей этой истории горжусь.
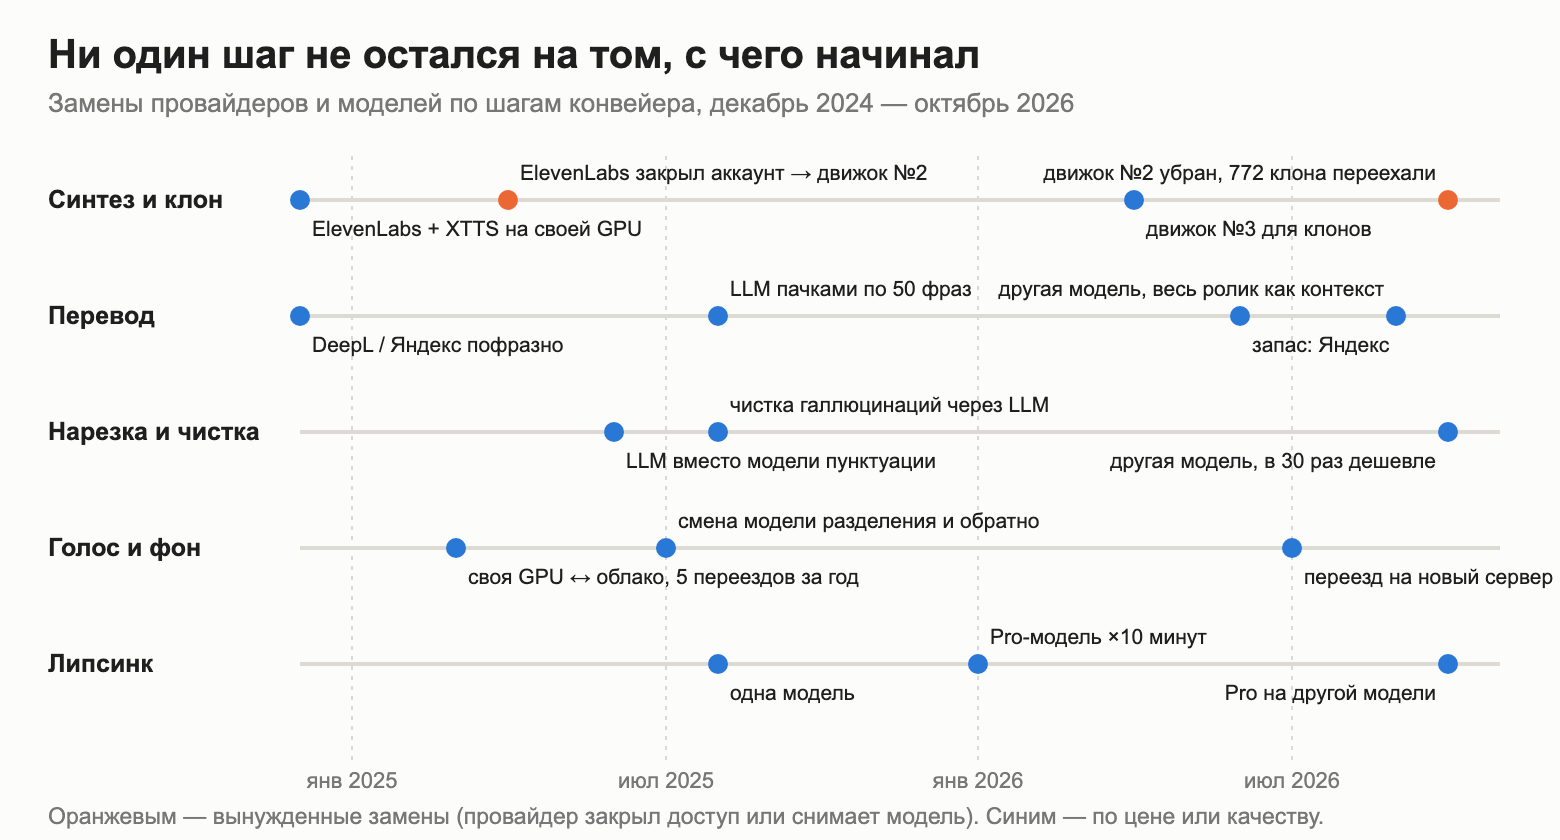
Отдельный жанр — текст ошибки, который видит пользователь, когда синтез лёг. Он менялся вместе с причинами: «голос временно недоступен» → «работы на стороне интернет-провайдера» → «масштабный сбой Cloudflare» (ноябрь 2025) → «технический сбой» → «ошибка синтеза речи». Историю интернета из России можно восстанавливать по git blame одной строки.
В тридцать раз дешевле за один день
Языковые модели идут через агрегатор, с продакшена — только через прокси. 29 сентября перевод переехал на модель в двадцать раз дешевле за токен. Я, честно, ждал подвоха: читал переводы глазами на 15 задачах в 13 языковых парах. Подвоха нет — новая нигде не хуже, а на грузинском, казахском и тамильском заметно лучше. И у старой 4,8 % задач не переводились с трёх попыток и уходили в запасной переводчик, у новой за первую неделю — ноль.
9 октября туда же переехала нарезка длинных кусков на предложения. Семь реальных сегментов, структура ответа верная у обеих 7 из 7, семь вызовов — 0,24 доллара против 0,007. В тридцать раз. За один день работы.
Если вы платите за LLM по прайсу годичной давности — пересчитайте. Модели дешевеют быстрее, чем мы успеваем их перепроверять. Я сам два месяца собирался.
Две ошибки за месяц, обе наши
Первая — ассистента. С сентября код у меня в основном пишет ИИ: я ставлю задачу, читаю изменения, коммичу и выкатываю сам. 8 октября при деплое он выполнил на продакшене php artisan config:cache. Зачем — не объяснил (я спрашивал). В коде ссылки на файлы строятся через env('APP_URL'), а с кешем конфига env() возвращает null. Ссылки ушли на GPU-машину без домена, та ответила «невалидный URL», и полтора часа все новые задачи падали с формулировкой «сбои в сети провайдера». Десятки задач; минуты вернулись автоматически, часть перезапустил руками. В инструкции ассистенту теперь строка «никогда не запускать config:cache». Он, кстати, сам её и написал.
Вторая — моя, и она глупее. Локальная копия проекта держит те же ключи провайдеров, что продакшен, и базу — дамп с продакшена. 18 сентября я чистил тестовые клоны у провайдера по маске имени и снёс девять боевых. Спасло то, что клон пересоздаётся из вокала при следующем синтезе. Правило с тех пор: у провайдеров ничего не удалять по маске. Никогда. Даже если очень похоже на тест.
Один человек вместо отдела
В репозитории 1 017 коммитов, все с сообщением «First». Коммит у меня — это деплой: git add., коммит, выгрузка. Разработчик один, называть коммиты не для кого. Знаю, что сейчас кто-то из вас поморщился. Переживу.
Вместо отдела эксплуатации — список проверок с датами. После каждого выката — проверка через два, семь и четырнадцать дней: что сломалось, что с конверсией, не упали ли деньги. Панель в админке на каждый запрос считает остаток у провайдеров, диск, воркеры, очередь, сбои за сутки. Поддержка — 163 письма за год плюс свой Telegram-бот (вебхуки из России не работают, бот ходит за обновлениями сам, через прокси). Ассистент, который пишет код, — тоже часть «отдела». Так что ошибки теперь на двоих, см. выше.
Что бы я сделал иначе
Запасной провайдер на каждом шаге с первого дня, а не после первого закрытого аккаунта.
Таймаут и повтор на каждый внешний вызов. Каждый. Тот, у которого их нет, упадёт в самый загруженный вечер — проверено.
Не держать боевые ключи в локальной копии.
Не платить за диск «на всякий случай».
А очередь в MySQL и одно ядро — оставил бы. Масштабировать нужно не железо, а запасные пути.
«А Яндекс Браузер переводит бесплатно»
Этот вопрос мне задают в каждом втором комментарии, отвечу заранее. Переводит, и хорошо. Я сам так смотрю ролики — нажал кнопку и смотришь. Только у зрителя на выходе нет файла, а у меня весь трафик — люди, которым файл нужен: свой курс, реклама, карточка товара. Это разные задачи, и с Яндексом я не конкурирую. Пока.
Сервис — speeek.io, если кому интересно потыкать то, что я тут описал. Вопросы про внутрянку — в комментарии, отвечу.