Этот текст написан в Сообществе, в нем сохранены авторский стиль и орфография
Самая странная статья расходов в моём проекте — не сервер и не реклама. Это нейросеть, которая разбирает голосовые заметки. Вчера вечером я добровольно увеличил эту статью в три раза.
О Сообщнике Про
Архитектор систем управления. Специализация — системы управления для товарного бизнеса: производство, маркетплейсы, опт и онлайн-продажи. 18 лет в разработке: от кода до проектирования рабочих систем. Лично занимаюсь архитектурой, интеграциями.
Это новый раздел Журнала, где можно пройти верификацию и вести свой профессиональный блог
Началось с бытового раздражения. Вечером, как обычно, ставил себе задачи в своём же приложении: наговорил пять фраз, четыре превратились в записи, а пятая крутилась около 20 секунд. Обычно на это уходило семь.
Почему двадцать секунд — это дорого
Сервис голосовой. Человек говорит в телефон, приложение делает задачу или заметку и присылает напоминание. Между фразой и итоговой записью стоит вызов модели нейросети.
Если ответ идёт 20 секунд пользователь решает, что приложение зависло. Закрывает его и следующего раза он просто может не дать.
Получается, что медленная модель стоит очень дорого — потерянного пользователя
Что показал старый тест
Тест я собрал ещё в августе, когда выбирал самую оптимальную из доступных моделей: девять сценариев из продукта, по три повтора. Тогда основная модель отвечала за 6,8 секунды и стоила 0,0043 ₽ за запрос.
Прогнал вчера: 18,5-19,9 секунды. Модель не сломалась, она просто стала медленной. В облаке это обычная история: провайдер меняет маршрутизацию, добавляет очередь.
Какие модели я использовал
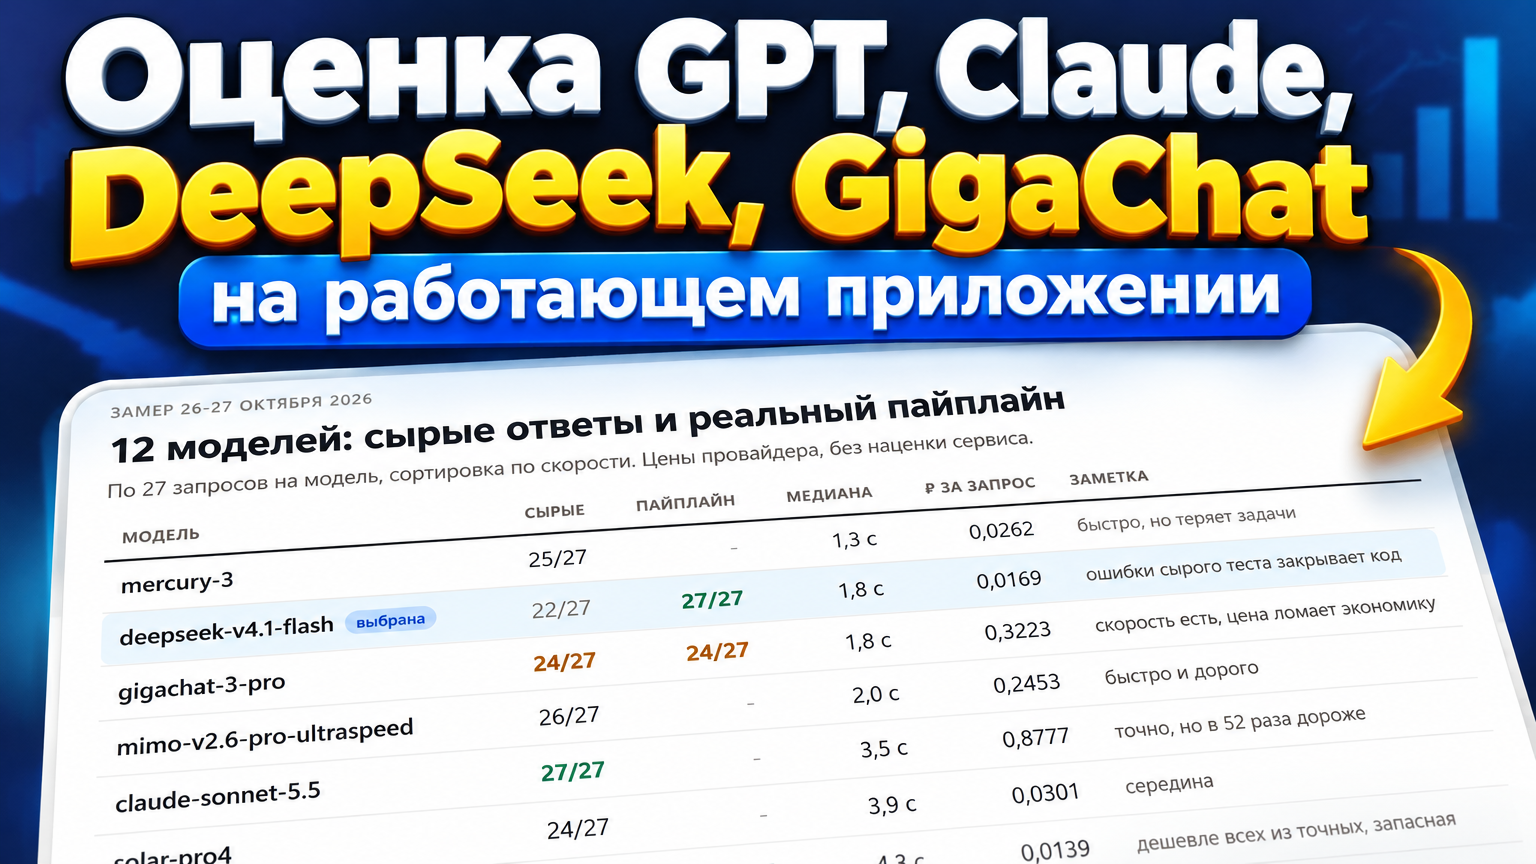
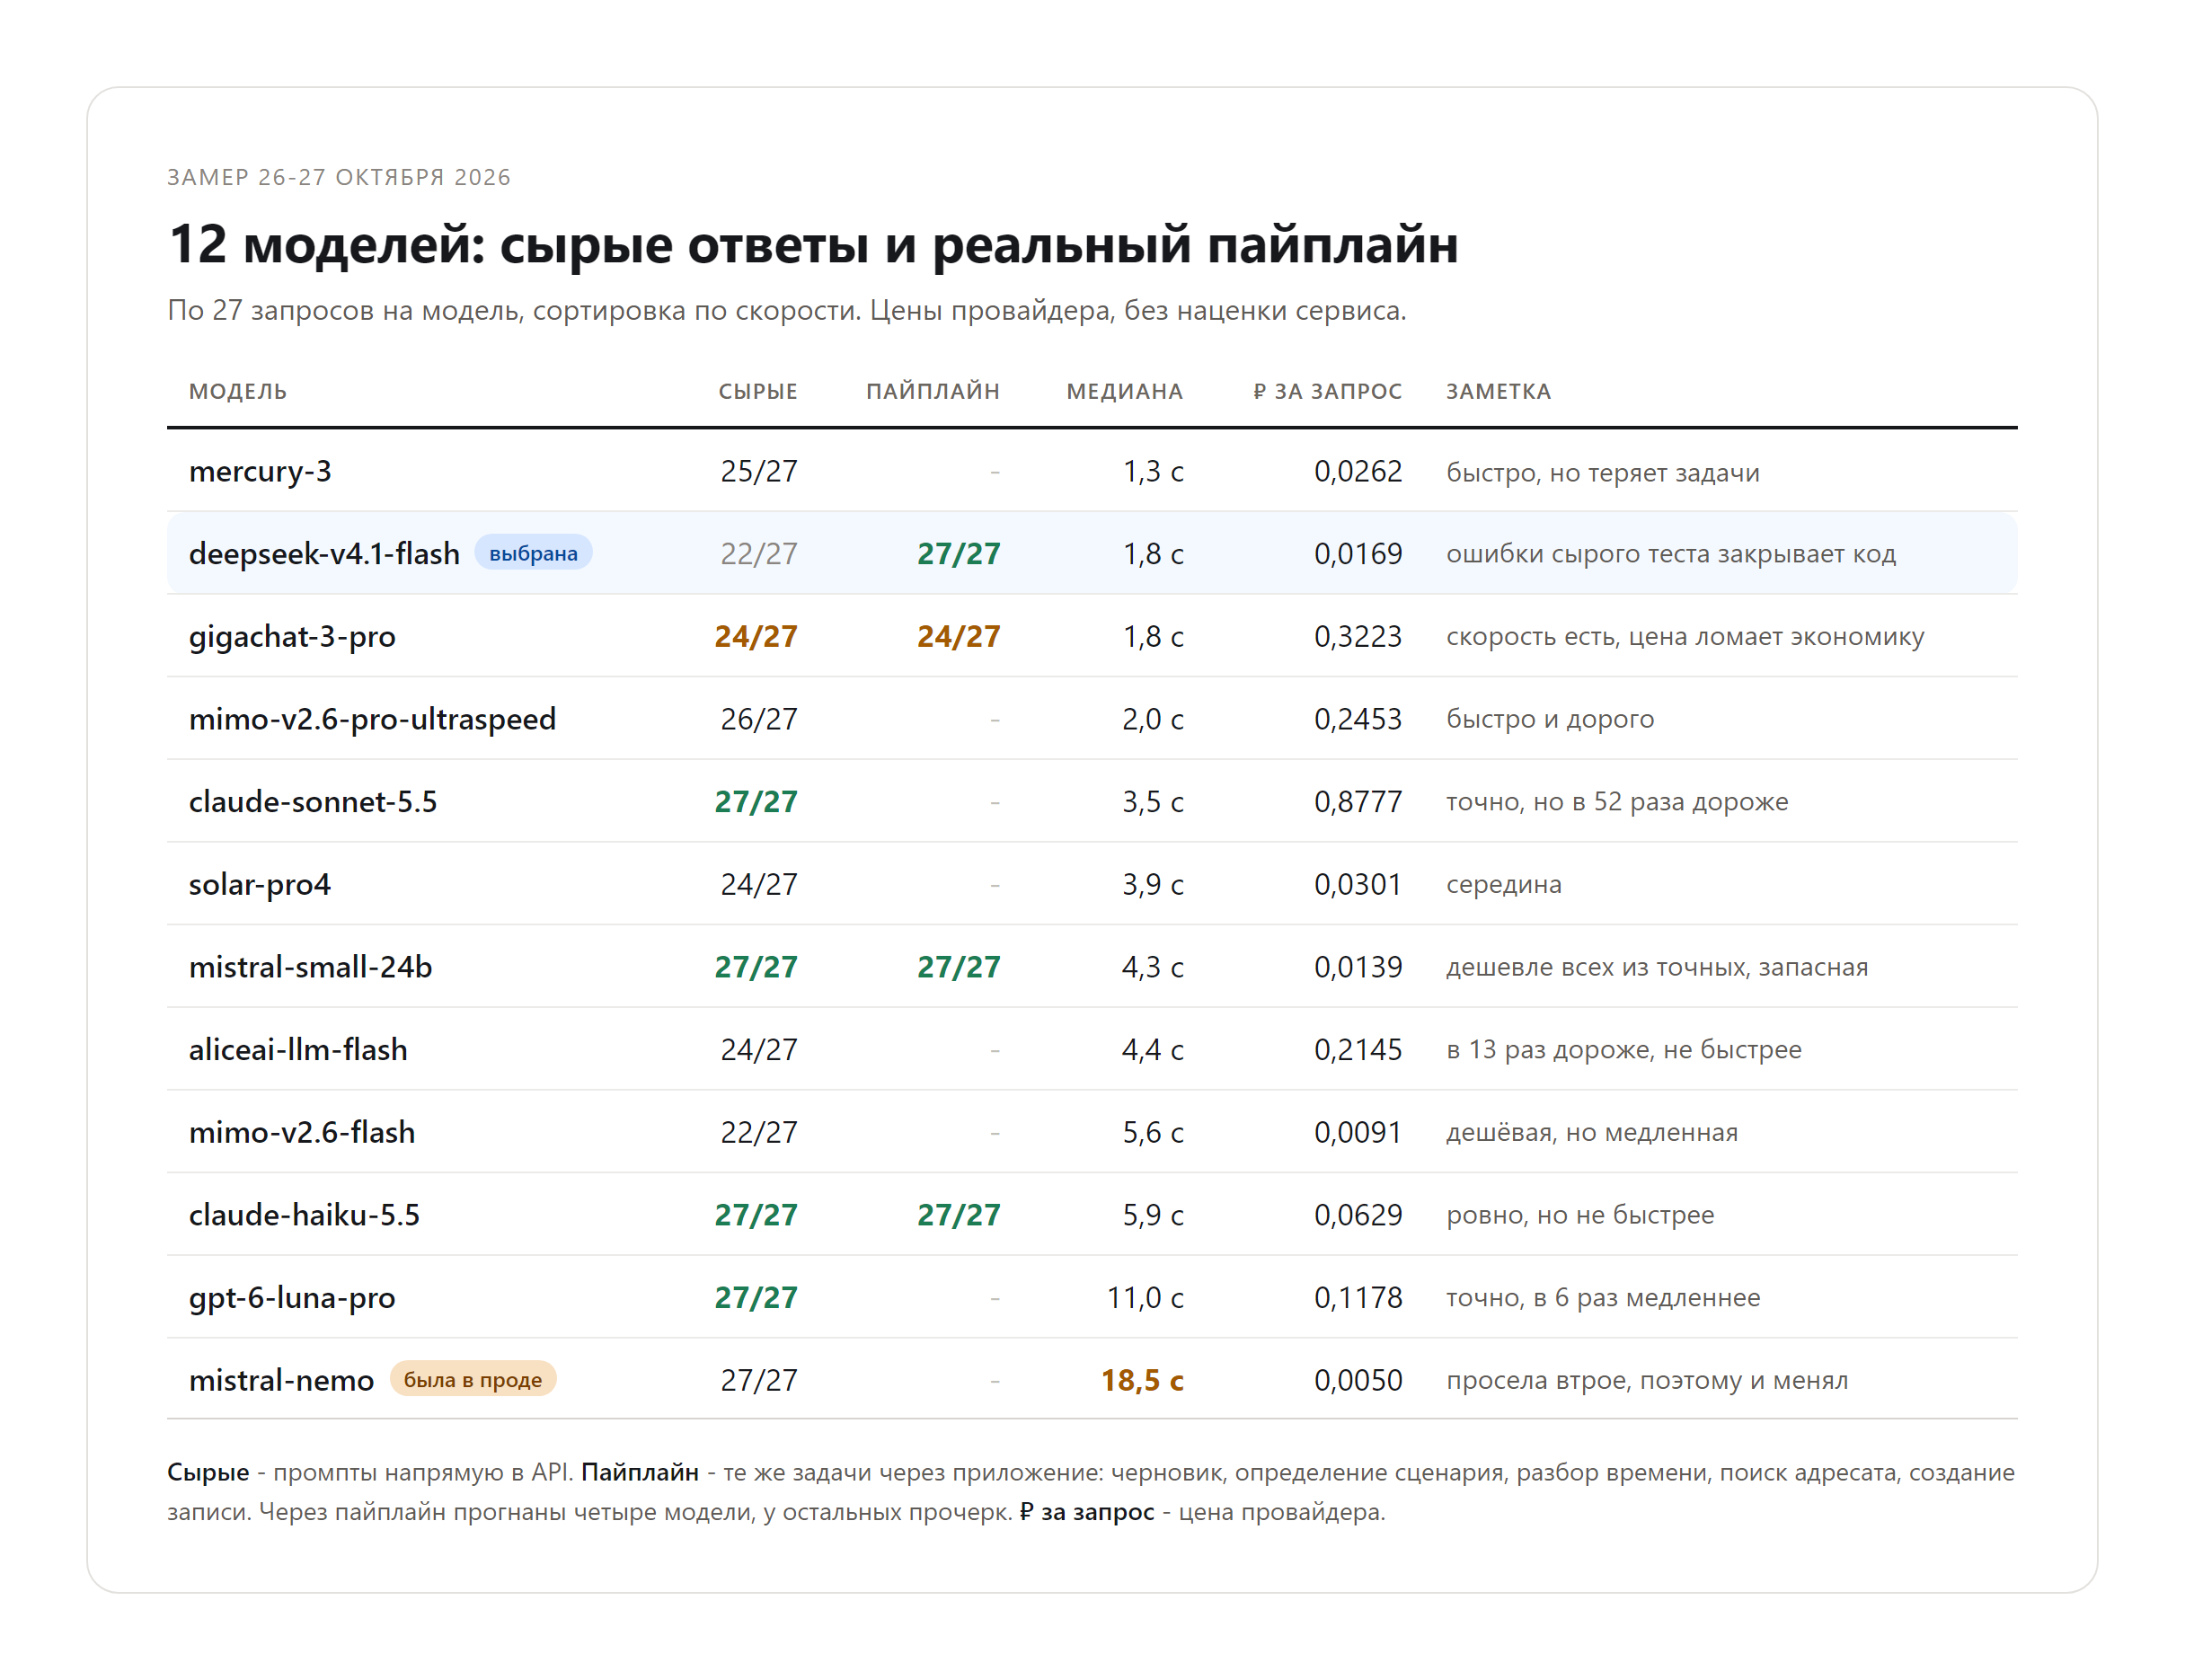
Добавил к набору обновлённый deepseek от 17 октября, GPT-6, Claude 5.5 в двух вариантах, Alice и GigaChat. Вышло 12 моделей, по 27 запросов.
Цифры по скорости и деньгам:
- DeepSeek-v4.1-flash — 1,8 секунды, 0,0169 ₽;
- GigaChat 3 Pro — 1,8 секунды, 0,3223 ₽ (в 19 раз дороже);
- Claude Sonnet 5.5 - 3,5 секунды, 0,8777 ₽ (в 52 раза дороже);
- Claude Haiku 5.5 - 5,9 секунды, 0,0629 ₽;
- GPT-6 Luna pro — 11 секунд, 0,1178 ₽;
- Alice LLM Flash — 4,4 секунды, 0,2145 ₽;
- прежняя модель — 18,5 секунды, 0,0050 ₽.
Что я выбрал и сколько это стоит
DeepSeek. Дороже прежней модели в 3,4 раза и быстрее в десять.
В месяц у активного пользователя примерно 90 действий. Было 0,0043 ₽ за запрос, стало 0,0169 ₽. В пересчёте на месяц: около 39 копеек против 1 рубля 52 копеек. Разница — рубль с небольшим.
За этот рубль я получаю ответ, который приходит, пока человек не убрал телефон в карман.
Как я проверил, что не ошибся
Сегодня прогнал четыре модели через реальную обработку приложения, а не только через сырые запросы. DeepSeek дал 27 из 27 и медиану 1,8-3,0 секунды.
В сыром тесте у него было 22 из 27 и это важная деталь. Часть ошибок закрывает код: сложную дату считает парсер, адресата в семейной задаче ищет резолвер по списку обращений. То есть платить за "самую умную" модель не всегда нужно — иногда дешевле забрать часть работы в код.
Тестировал только текстовые задачи. Фотографии разбирает в текст и заметки отдельная модель DeepSeek v4 Flash Vision, её я не трогал с сентября
Вывод
Модель нейросети в работающем приложении — это расходник, у которого портится то цена, то скорость. Единственная страховка — свой тест, который можно прогнать за вечер. У меня он стоит меньше сотни рублей и вчера поймал просадку раньше, чем это заметили пользователи.
А вы считали во сколько вам обходится дополнительная секунда ожидания?