От Word по почте до ИИ-скиллов: обсудим эволюцию документации и зачем нейросетям бизнес-контекст
Этот текст написан в Сообществе, в нем сохранены авторский стиль и орфография
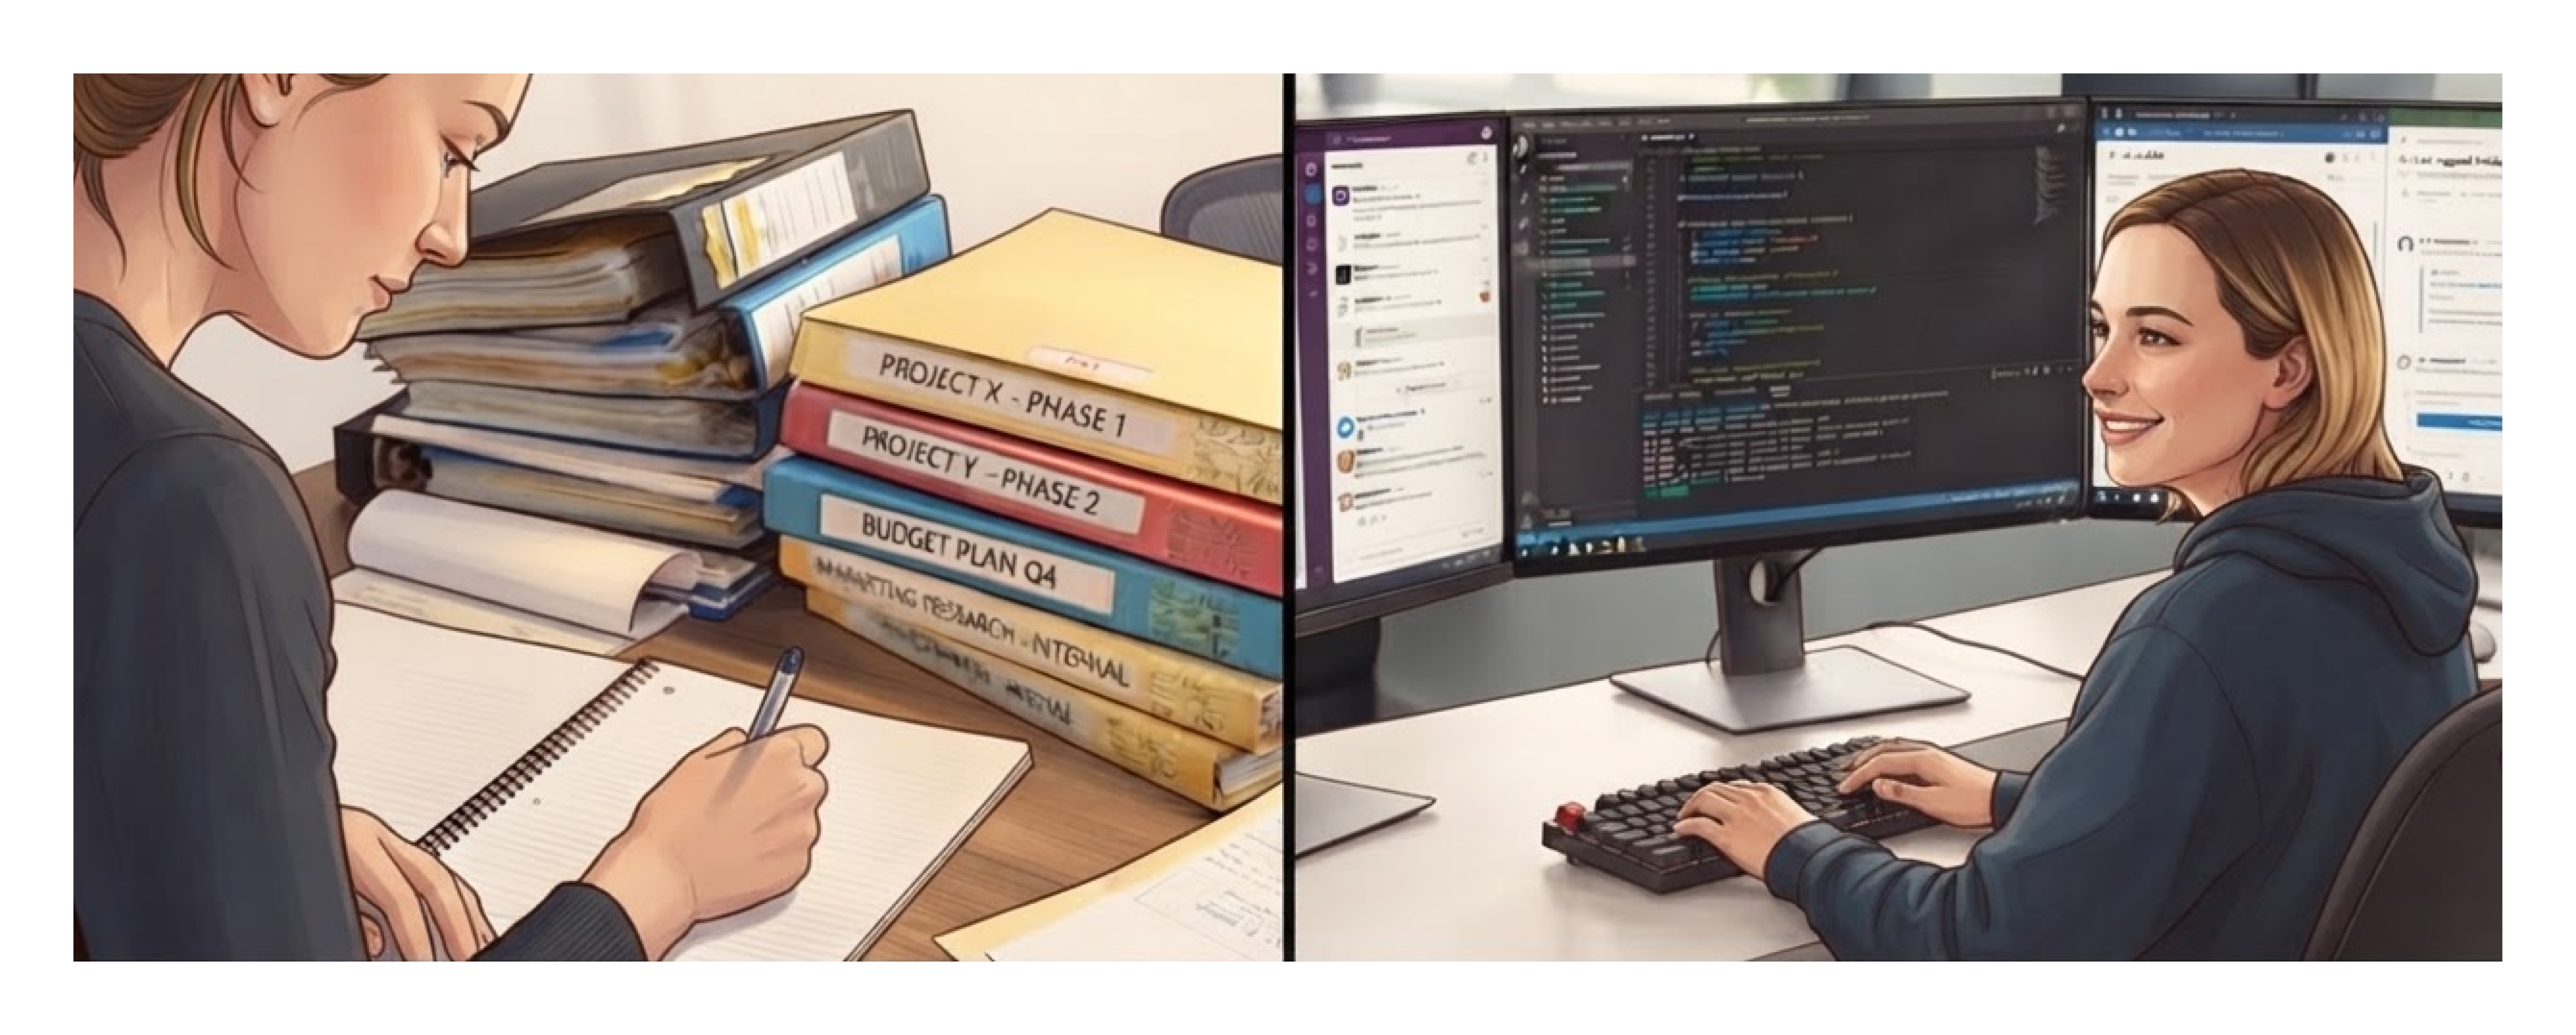
Мы прошли долгий путь от пересылки ТЗ в Word по электронной почте до автоматической генерации документации нейросетями прямо из Merge Request разработчика. Зачастую это происходит вообще без участия аналитика вплоть до этапа итогового ревью. Но делает ли автоматизация нашу документацию лучше?
В этой статье я хочу оглянуться на эволюцию того, как мы вели проектную документацию, обсудить одну неочевидную проблему работы с ИИ, о которой мало кто задумывается, и показать, как с этим бороться. А в конце я поделюсь полезными материалами — примером репозитория документации для двух подходов (классический водопад с элементами канбана и чистый скрам) с готовым ИИ-скиллом для анализа изменений в коде.
О Сообщнике Про
Ведущий системный аналитик. Пишу о системном анализе и ИИ.
Это новый раздел Журнала, где можно пройти верификацию и вести свой профессиональный блог
Эволюция согласований: от сетевых дисков к Git
Сразу сделаю дисклеймер: красивая эволюция, которую я сейчас опишу, происходила именно в моей карьере. Конечно, Waterfall сменился Scrum-ом в мировой практике ещё до того, как я начала работать аналитиком. Но, сменив множество проектов и пройдя сотни собеседований, я накопила выборку, показывающую общие тенденции.
Эпоха Word и почты
Когда я только пришла в системный анализ 8 лет назад, мы писали документацию в Word и отправляли ее по почте на согласование. Хранилась она на сетевых дисках или в Google Drive. Версионирование велось прямо в названии файла (ТЗ_v1.5_final_FINAL.docx). Комментарии заказчики оставляли прямо в документе, чаще всего в тексте с цветным выделением, а мы переписывали их в эксель-таблички и проставляли вручную статусы решения открытых вопросов по итогам встреч для внутреннего контроля. Документация была классической, по Вигерсу: отдельный документ Vision and Scope, отдельные бизнес-требования, гигантское ФТ+ТЗ (которое за год разрасталось страниц на 250), пользовательские инструкции с миллионом скринов и подробную программу приемо-сдаточных испытаний. На проектах с госзаказчиком это был тот же Word, но со строгими требованиями оформления отступов по ГОСТу.
Эпоха Confluence и Скрамбана
Дальше пошла череда проектов с документацией в Confluence. И заказчики, и мы учились с ним работать, реестры замечаний умерли сами собой — комментарии удобно подсвечивались прямо на страницах. Процесс стал ближе к скрам-канбану: инкременты, спринты, доски в Jira, но без строгих правил классического Scrum. Документация разделилась на три пространства: требования в работе, актуальное состояние системы (AS-IS) и пользовательские инструкции.
Эпоха Git, стикеров и ИИ
Сейчас я наблюдаю новую стадию эволюции. Документации становится меньше, базы знаний переезжают из Confluence в Git (в подходе Docs-as-Code или хотя бы просто в разметке markdown), схемы и комментарии в коде постепенно вытесняют текст, записи и авто-протоколы встреч вытесняют заверенные в почте ответными письмами «Возражений нет» протоколы встреч. Требования часто фиксируются только на стикерах в Figma и в тикетах Jira, а в документацию сразу вносится обновление актуального состояния системы.
Но появилась новая проблема. Документация уже вовсю генерится через ИИ, а часто и не генерится вообще, исходя из мысли: «потом ИИ и так прочитает код».
На мой взгляд, пока что ИИ не решает главной функции аналитика — удержание контекста. На вопрос от менеджера «Почему мы сделали вот это и теперь оно мешает работать вот этому?» всё равно приходится перекапывать доски, протоколы, код и вызванивать старожилов команды.
Главный инсайт: Для кого мы теперь пишем документацию?
На этой неделе я перерабатывала гигантский объем документации, сгенеренной через ИИ. И перерабатывала я ее… тоже через ИИ. Руками писать приходится всё меньше, но нейросети — это лишь инструмент, а не ответственный за документацию всезнающий член команды.
Недавно мы дискутировали с лидом разработки. Он спросил: «Что мы вообще дальше будем делать с документацией? Неужели разработчики будут ее читать?»
Скорее всего, не будут. Они продолжат читать код и сообщения в чатах. Но вот что по-настоящему важно: помимо бизнес-пользователей теперь документацию будет читать ещё и ИИ на следующей итерации доработок.
То, что ИИ по умолчанию складывает в доку (описание диффа, затронутые методы, использованные API), для последующего чтения практически бесполезно. Следующий ИИ-агент при планировании доработок сам посмотрит код, точно так же, как сделал бы это живой разработчик.
Но мы, аналитики, понимаем, что вопрос «Какие изменения где нужны?» — не первый. Первый вопрос звучит так: «Почему нам нужны именно эти изменения, уверены ли мы в них, и на что они повлияют?»
Это именно тот пласт знаний, который жил в головах менеджеров, аналитиков и в аналитической документации. При перестройке процесса в сторону продакт-инжиниринга он рискует улетучиться быстрее всего. Если разработчик получает задачу от бизнеса и сразу идёт реализовывать её с ИИ, машина разберется, как это сделать технически. Но она не оценит критически само предложение, а часто не оценит ее и архитектурно, если разработчик сам не задастся такой целью. В крупном enterprise это приводит к лавинообразному техдолгу, когда бантики вешаются туда, где внутри никогда и не было логики, была лишь заготовка под будущие доработки, о которых все забыли в следующем же спринте.
Как избежать хаоса: от промптов к скиллам
Первый шаг мы уже сделали — перенсли документацию в Git (Markdown) и актуализируем данные сразу там. ИИ сможет работать с такой базой и искать артефакты предыдущих решений.
Второй шаг — создание ИИ-скиллов. Скилл — это преднастроенная инструкция для ИИ-агента, которая задает порядок работы и критерии качества. В инструкции невозможно зашить годы экспертизы и майндсет сеньор-аналитика, но такой скилл позволит сэкономить часы на ревью и заставит машину сохранять бизнес-контекст, а не только перечислять затронутые эндпоинты.
Важно отметить, что само создание скилла тут не главная сложность. Скилл любая ИИ по вашему точному запросу со списком правил создаст за 10 минут. Важно же, чтобы его использование прижилось в процессах. В моем случае база уже была подготовлена: компания сама активно идет к концепции независимых ни от кого продакт-инженеров, репозитории с различными скиллами уже готовятся, руками ни код, ни документацию уже почти никто не пишет. Тем не менее, я прошла следующие шаги:
- подсветила проблему руководству, чтобы обосновать свои трудозатраты;
- подняла вопрос на комьюнити аналитиков и взяла на себя инициативу подготовить скилл;
- разработала сам скилл и несколько раз потыкала аналитиков, чтобы убедиться, что они если не "за", то хотя бы не против;
- обсудила правильное расположение скилла и расположение всех ссылок на него в общем репозитории с лидом разработки, чтобы он не пылился в нашем репозитории, куда и так никто не заходит, а был включен в флоу разработки фичей с ИИ.
Поможет ли это сделать документацию идеальной? Без заинтересованных в этом людей — вряд ли. Разработчики всё так же не будут делать на этом фокус, если руководству это не будет важно. Но хотя бы включение напоминаний для агентов в общие скиллы позволит сделать документацию ненулевой, что уже полезнее, чем ничего. А дальше, надеюсь, при первых сложностях с дальнейшей работы без хранения истории принятых решений, и руководство тоже задумается и будет делать фокус не только на том, чтобы всё было сделано как можно быстрее, ведь без анализа и документации страдает качество итогового продукта.
Практика: Шаблоны и ИИ-скилл для вашей команды
Я подготовила публичный репозиторий с моим подходом к организации документации в командах, работающих с ИИ. Шаблоны задают структуру, а скиллы задают ИИ порядок работы с ней. Человек проверяет результат и принимает решения.
В репозитории представлены два комплекта для разных потребностей:
1. Комплект Hybrid (Итерационная разработка с подробным согласованием)
Подходит командам, которым важно согласовать изменение с бизнес-заказчиком и сохранить описание, понятное без чтения кода.
Особенность: Доработка проходит путь от бизнес-требований и ФТ до архитектурного решения (ADR). Документация позволяет разобраться в поведении системы независимо от исходной задачи.
Она нацелена не только на команду, но и на внешних стейк-холдеров, которые могут почитать текст и понять, были ли реализованы их запросы и как.
Этот комплект больше ориентирован на написание и чтение человеком, но скилл можно прикрутить и к нему, переиспользовав основу скилла из второго проекта.
2. Комплект Scrum (Актуальная документация для ИИ-команд)
Разработчик вместе с ИИ изучает запрос, определяет влияние на продукт и обновляет связанные документы прямо в ходе реализации.
Особенность: Детали реализации остаются в коде, а в документации (в сквозных бизнес-процессах и блоках AI Context) сохраняется бизнес-смысл, причины решений и связи. Это идеальный контекст для ИИ.
В репозитории лежит готовый скилл document-scrum-mr. Это инструкция для агента, анализирующего Merge Request.
Как это работает: вы передаете агенту этот скилл, задачу из трекера, diff кода и доступ к рабочей документации. Агент:
- Сопоставит реализацию с бизнес-целью.
- Уточнит недостающие причины изменений.
- Определит, какие Markdown-файлы нужно обновить.
- Подготовит согласованный набор правок и обновит AI Context.
Вам остается только провести человеческое ревью (например, собрать два аппрува от команды).
Материалы доступны по лицензии CC0 1.0 — забирайте, адаптируйте под свои проекты и делитесь с коллегами.
А как вы думаете?
Есть ли у вас уже опыт написания таких аналитических скиллов? Или в вашей компании аналитиков пока никто не собирается сокращать и автоматизировать? Делитесь в комментариях!