Arena AI — бесплатный сервис для сравнения популярных ИИ-моделей. Что там доступно и как пользоваться
Arena — это платформа, где один и тот же запрос можно отправить сразу двум нейросетям, сравнить ответы и проголосовать за лучший.
Из голосов складывается публичный рейтинг нейросетей. Для пользователей сервис бесплатный. В нем можно попробовать модели для текстов, кода, картинок и видео и понять, какая лучше справляется с задачами.
Расскажу, какие нейросети есть в Arena, чем различаются режимы работы и на что смотреть при сравнении ответов.
Что такое Arena и какие нейросети там доступны
Обычно ИИ-модели сравнивают по бенчмаркам — наборам заданий с заранее известными правильными ответами. Но нейросети научились распознавать, что их проверяют, и могут вести себя иначе, чем с обычными пользователями. Например, когда модель замечает, что ее тестируют на склонность поддакивать, она может начать спорить с ошибочными утверждениями, а в обычном чате продолжит соглашаться с собеседником. В итоге тест показывает хороший результат, который расходится с реальной работой модели.
Исследователи из Калифорнийского университета в Беркли в 2023 году запустили Chatbot Arena и предложили другой способ оценки. Человек задает любой вопрос сразу двум анонимным моделям, читает оба ответа и выбирает лучший. Проверить, тест это или нет, модель не может: вопросы присылают обычные пользователи со своими задачами.
Сначала Chatbot Arena работала на сайте исследовательской группы LMSYS, потом у нее появился собственный сайт, а название сменили на Arena.
Arena бесплатна для обычных пользователей и зарабатывает на компаниях. Разработчики нейросетей и бизнес могут заказать подробную аналитику о работе моделей на основе оценок пользователей платформы. Например, компания может выяснить, какая нейросеть лучше подходит для ее внутренних задач.
В сервисе собраны модели крупных американских и китайских разработчиков. Например, там есть разные версии нейросетей от OpenAI, Google, Anthropic, xAI, DeepSeek, Alibaba и других компаний. Из российских разработок Arena оценивает только видеомодели Kandinsky 5.0 Video Pro и Lite. В рейтинге генераторов видео по текстовому описанию они на 37-м и 44-м местах из 48.
Как устроена Arena
Сервис состоит из двух частей: чата, где нейросети отвечают на запросы, и рейтингов, которые складываются из голосов пользователей.
Чат. Расположен на главной странице arena.ai. Перед началом работы можно выбрать режим, по умолчанию стоит Battle Mode — анонимное сравнение двух моделей. О нем и других режимах подробнее расскажу чуть позже.
Также можно настроить тип задачи. По умолчанию стоит Auto: Arena сама определяет по запросу, что нужно пользователю. Вручную можно выбрать один из вариантов: текстовый чат, поиск в интернете, создание сайтов и приложений, генерация и редактирование изображений или видео.
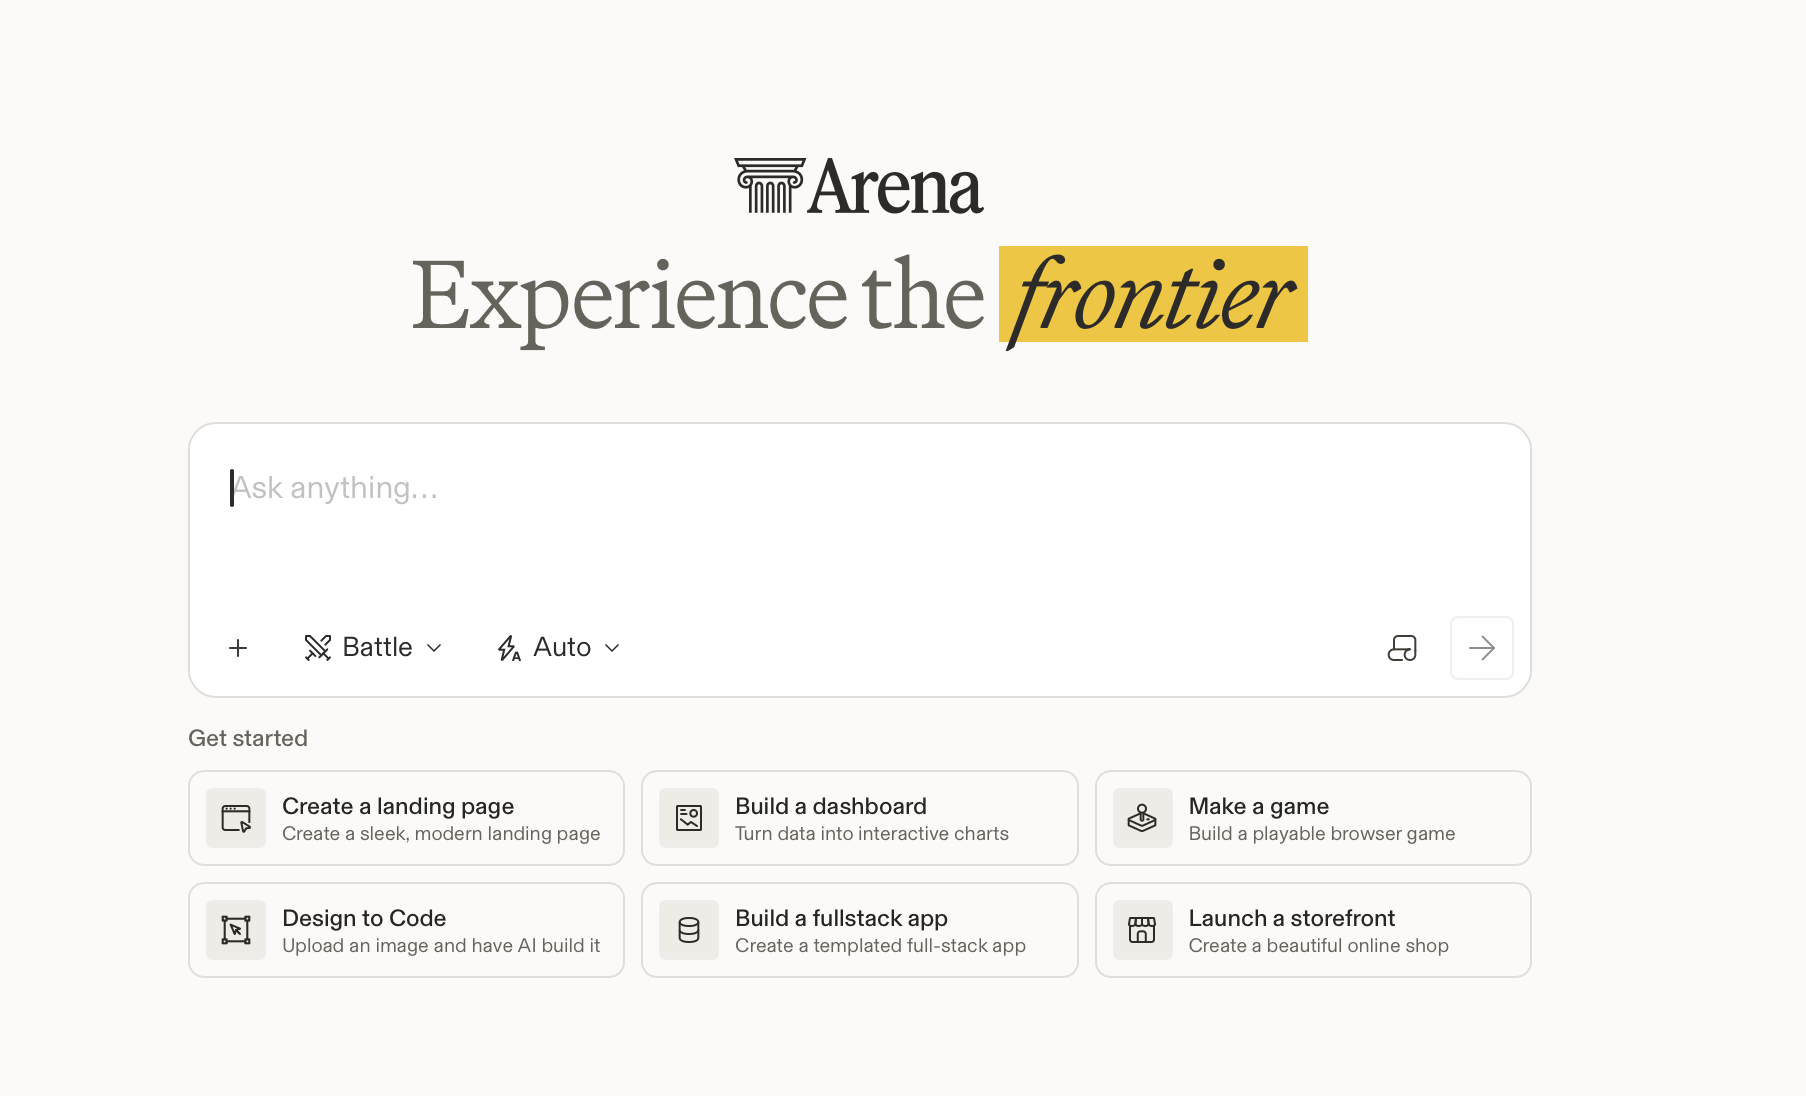
Без входа в аккаунт можно запустить только анонимное сравнение текстовых моделей. Чтобы выбирать модели самостоятельно, генерировать картинки и видео, нужно создать аккаунт. Зарегистрированным пользователям также доступно больше запросов, а история чатов сохраняется и синхронизируется между устройствами. Залогиниться можно через аккаунт Google или по электронной почте. Если до регистрации в Arena уже были чаты, они перенесутся в новый аккаунт.
При этом вне зависимости от авторизации количество запросов на Arena ограничено. Дневной лимит действует для каждого пользователя и обновляется через 24 часа. Платно снять ограничения нельзя, а размер лимитов компания не раскрывает. За время тестирования платформы в среднем я открывала по четыре новых чата в день, вела диалоги до 10 сообщений и ни разу не превысила лимит.
Рейтинги. Их можно найти по кнопке Leaderboard в меню слева и смотреть без регистрации.
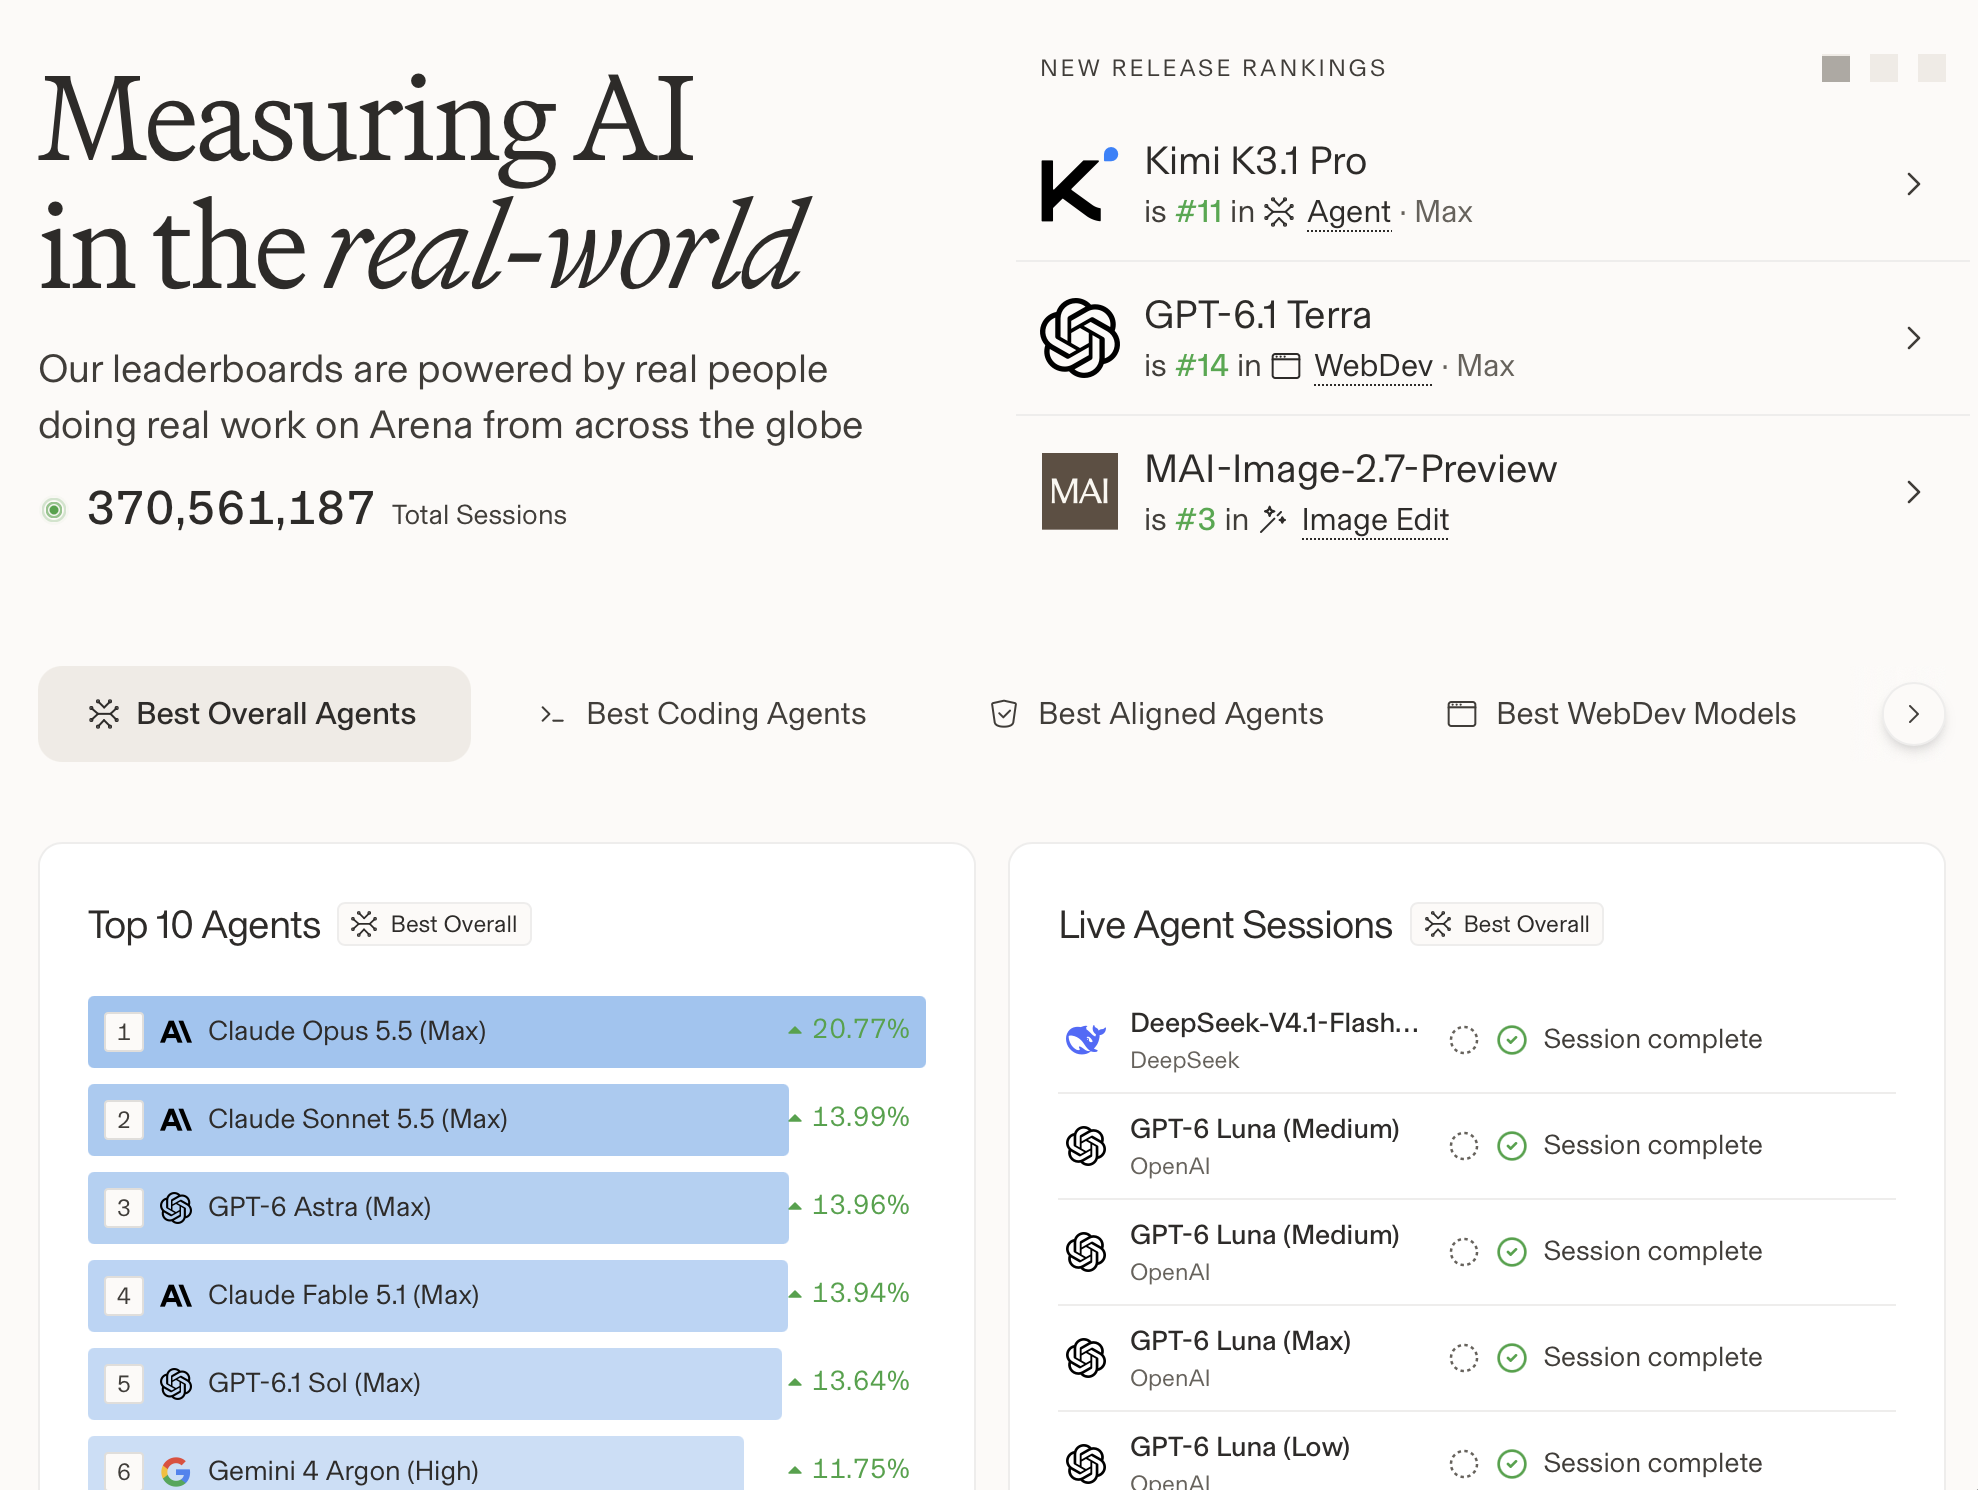
На Arena есть пять типов рейтингов:
- Agent — как модели справляются с многошаговыми задачами: найти информацию, написать и запустить код, собрать отчет.
- Chat — текстовые ответы, распознавание картинок, работа с документами и поиск в интернете.
- Code — создание сайтов, в том числе по картинке с макетом.
- Image — генерация изображений по описанию и редактирование фото.
- Video — создание роликов по описанию или по картинке и редактирование видео.
В некоторых рейтингах кроме общей оценки есть подкатегории. Например, у текстовых моделей их 29, в том числе «творчество», «математика» и «профессиональные тексты». У генераторов изображений — восемь, например «искусство», «портреты», «фотореализм». Лидеры подкатегорий могут различаться, поэтому изучайте ту, что ближе к вашей задаче.
Как Arena считает рейтинг
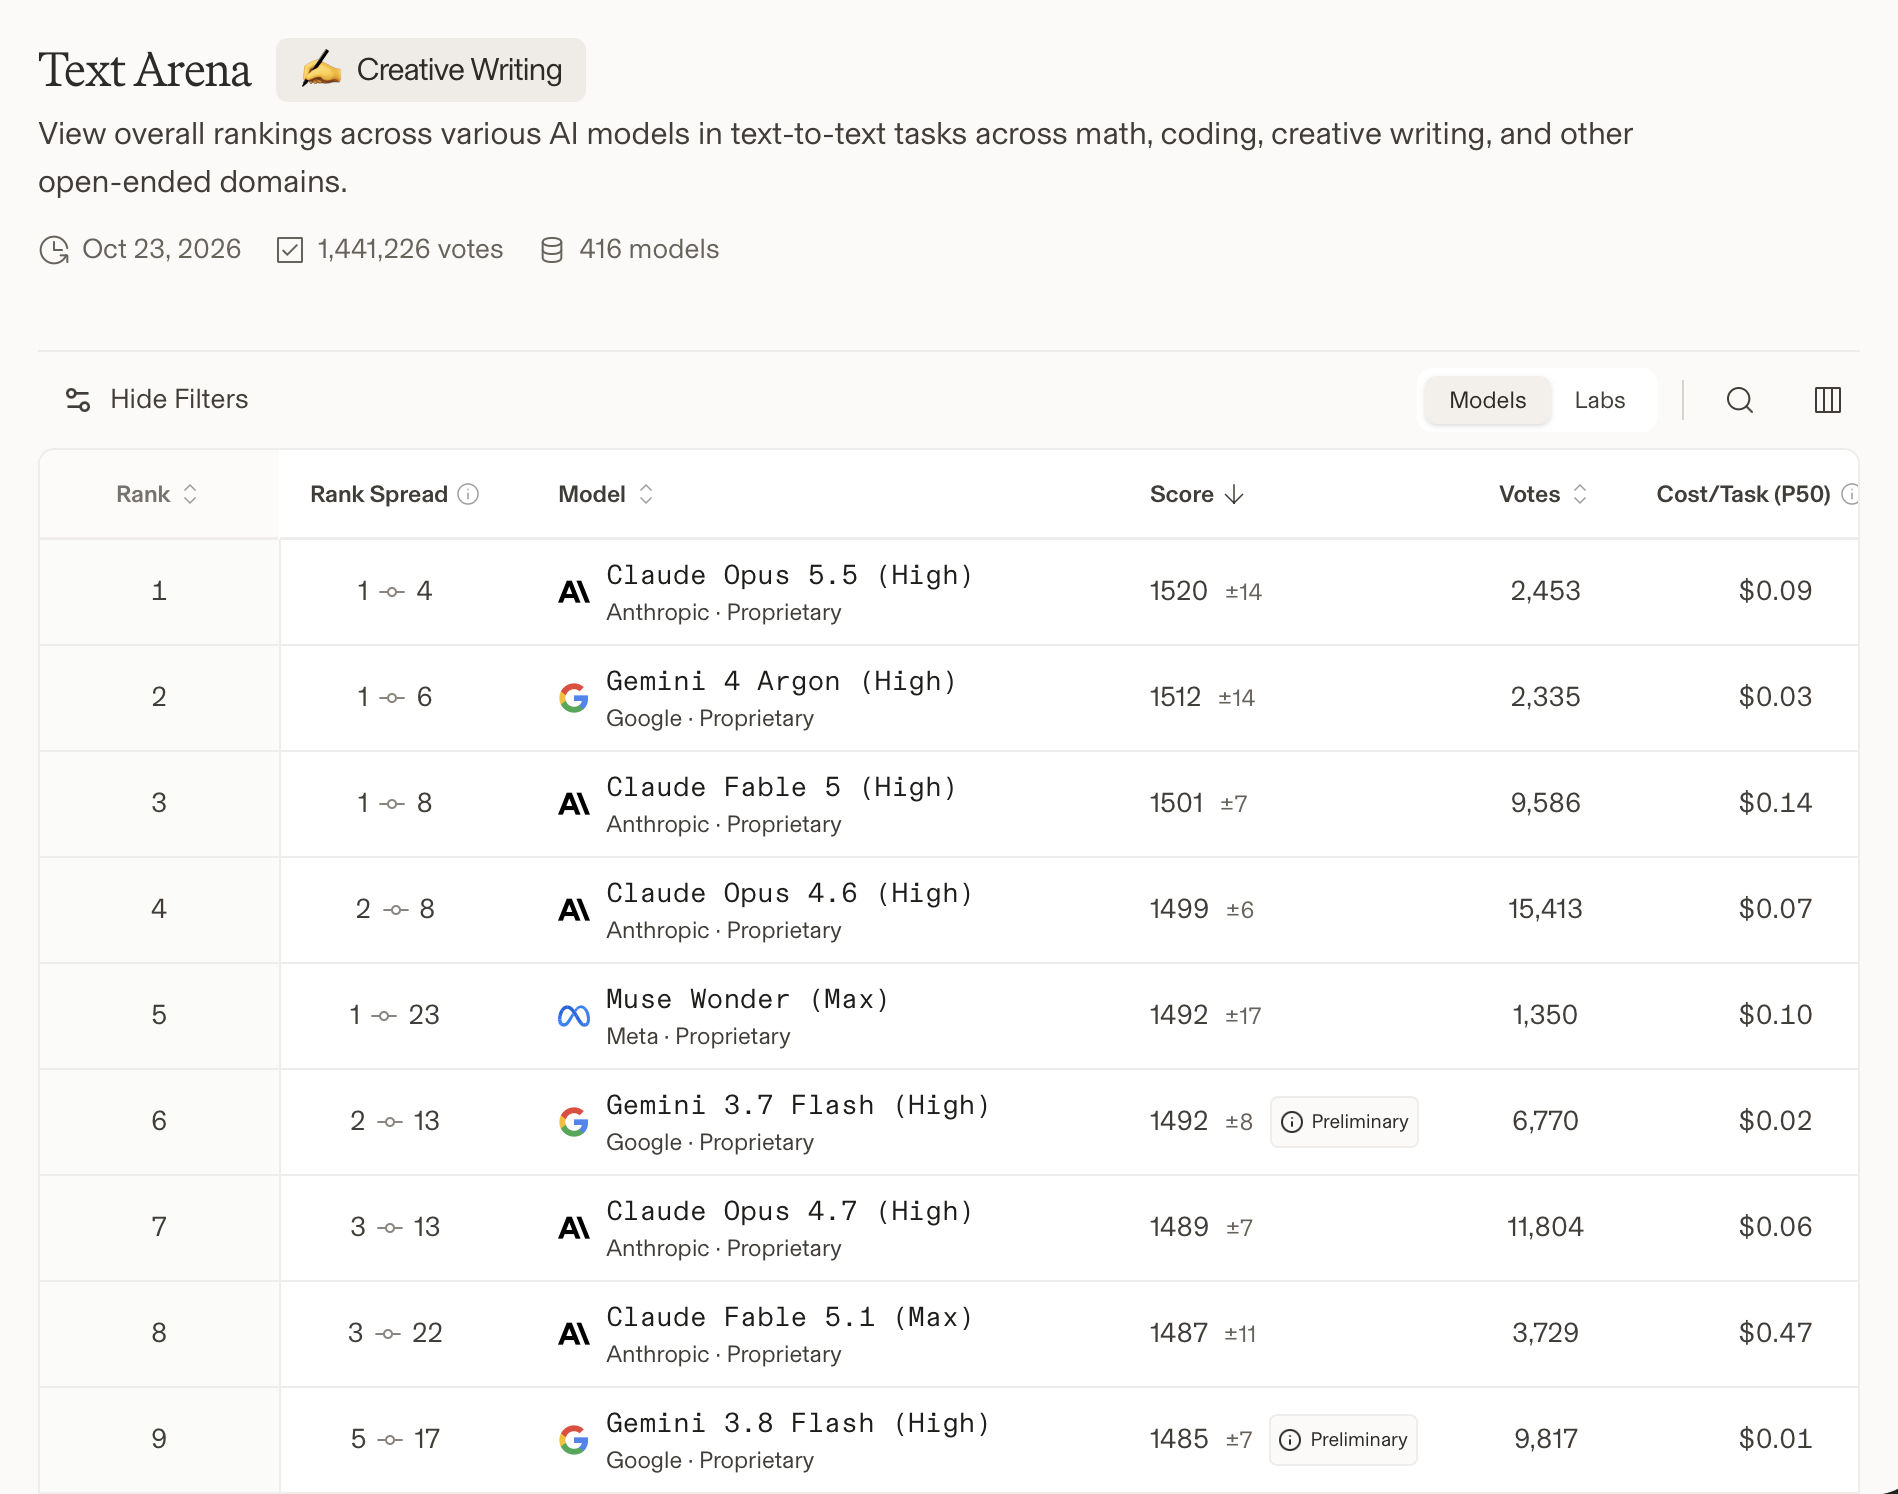
Место модели в большинстве рейтингов определяют баллы, которые Arena рассчитывает по методу Брэдли — Терри. Это статистический способ оценивать участников по результатам попарных сравнений, чем-то похожий на метод Эло у шахматистов. По баллам можно оценить, как часто одна модель выигрывает у другой: чем больше разница, тем чаще побеждает та, у которой рейтинг выше. Если разница — 100 баллов, она выигрывает примерно в 64% сравнений, если 200 баллов — примерно в 76%. При небольшом разрыве модели почти равны. Например, в рейтинге редактирования изображений на момент написания статьи у MAI-Image-2.6 оценка 1 428 баллов, у Grok Imagine Image 2.0 — 1 425, и первая выигрывает примерно в половине сравнений.
В рейтинге агентов оценка другая. Здесь модели не сравнивают попарно. Arena оценивает, как часто пользователи подтверждают, что задача выполнена, и как агент исправляет свои ошибки.
При расчете баллов сервис учитывает погрешность — чем меньше голосов, тем она больше. Поэтому в колонке Rank Spread показано, между какими местами на самом деле может находиться модель. Нейросети, которые оценивали до публичного релиза, имеют пометку Preliminary. Это значит, что их оценка предварительная и может измениться, когда модель выйдет в открытый доступ и появятся новые голоса.
Иногда в рейтингах Arena показывает нейросети с непонятными названиями. Это версии, которые компании проверяют до выхода. Самый известный пример — генератор изображений nano-banana. Летом 2025 года он появился в Arena анонимно и за время тестов собрал более 2,5 млн голосов. Потом выяснилось, что это Gemini 2.5 Flash Image, но кодовое название запомнилось пользователям — и Google сделала его официальным. Если модель проходит отбор и выходит официально, ее результаты попадают в рейтинг под настоящим названием.
Оценку пользователей можно смотреть не только по моделям, но и по разработчикам: для этого в таблице есть переключатель Labs. Там Arena показывает лучшую модель каждой компании, ее оценку и место в общем рейтинге. Так проще понять расстановку сил на рынке.

Как пользоваться Arena
Arena работает в России и дает доступ к моделям, которые официально здесь не представлены. Например, там можно генерировать картинки с помощью Gemini 3.1 Flash Lite Image. Чтобы воспользоваться этой моделью через официальный сайт нейросети, нужно заводить новый аккаунт в Google, использовать иностранный IP-адрес, а для платной подписки — еще и зарубежную карту. В Arena все это не требуется. Интерфейс платформы на английском, но запросы можно писать на русском: модели понимают их и отвечают на том же языке.
Для пользователей сервис доступен бесплатно на сайте, официального приложения у Arena нет. В App Store и Google Play можно найти приложения с названиями вроде Arena AI или LMArena AI. Их выпускают сторонние разработчики, к самой платформе они отношения не имеют.
Перед отправкой запроса Arena предупреждает, как обращается с данными. Под полем для ввода появляется плашка о том, что переписка и часть личной информации передаются разработчикам моделей и могут быть опубликованы в открытом доступе для исследований. Поэтому сервис просит не отправлять сведения, которые не хотелось бы делать публичными.
У сервиса есть четыре режима работы, и от выбора зависит, увидите ли вы названия моделей и попадет ли ваш голос в рейтинг.

Battle Mode. Режим демонстрирует, какая нейросеть лучше справляется с определенной задачей. Сервис показывает ответы двух моделей, но не открывает их названия, пока пользователь не проголосует. Можно выбрать лучший ответ или отметить, что оба хороши или оба плохи. Голоса из этого режима учитываются в общем рейтинге Arena.
Battle Mode пригодится, если вы привыкли к одной-двум нейросетям и хотите узнать, какие еще модели могут подойти для ваших задач. Например, нужно выбрать сервис для текстов рассылок: отправляете запрос и оцениваете два ответа, не зная, какие модели их написали. Или планируете отпуск и хотите понять, какой нейросети доверить маршрут.
Для теста я попросила модели придумать маршрут для поездки в Нижний Новгород с детьми. Моя сестра недавно ездила с семьей и друзьями в такое мини-путешествие, поэтому ответы моделей можно сравнить с реальностью.
Составь маршрут по Нижнему Новгороду для двух семей, всего 6 человек, в том числе два ребенка 10 лет. Приезжаем в первой половине дня пятницы из Москвы, уезжаем в воскресенье во второй половине дня. Предложи оптимальный маршрут, где остановиться, поесть и что посмотреть. Приедем на машине, но погулять пешком тоже хочется.
Оба ассистента расписали поездку по часам и учли, что едут дети, порекомендовали, в каких районах города стоит остановиться в апартаментах или отелях. В план они включили многие места, которые в реальности посетила сестра с семьей. Но подошли к задаче они по-разному.
Ассистент A сделал ставку на атмосферу: подобрал много мест и кафе с видами. Но не весь маршрут оказался оптимальным. Например, в первый день модель не предложила отдых после пятичасовой поездки и сразу отправила людей гулять. При этом по ее плану нужно несколько раз пройтись туда-обратно. В реальности моя сестра строила маршрут так, чтобы все было по пути.
Ассистент B больше думал о логистике. Он посчитал, сколько километров придется пройти за день, заложил перерывы в отеле, чтобы дети и водители отдохнули, предупредил об очередях на канатную дорогу и рассчитал время дороги домой. В отличие от Ассистента A, он подсказал сайты, где можно поискать апартаменты, и дал рекомендации, на каких улицах лучше не селиться.
Маршрут этой модели понравился больше: точки расставлены по пути, не приходится возвращаться туда, где уже были. Смутили только предложенные кафе и рестораны, в основном это были пельменные. А сестре показалась сомнительной рекомендация доехать до Нижегородской ярмарки: внутри делать нечего, а увидеть здание снаружи можно по пути.
В итоге лучшим выбрали ответ ассистента B, им оказалась модель muse-wonder-max за авторством Meta*. Под ассистентом А скрывалась модель hy4-preview китайской компании Tencent.
Side by Side. Режим подходит, когда выбор сужен до двух нейросетей и нужно решить, на какую из них оформить подписку. Модели выбирают вручную, их названия видны сразу, поэтому голоса в рейтинг не идут. Так можно сравнить, например, привычный для вас инструмент с моделью, которой еще не пользовались. Это удобнее делать на собственных задачах: бухгалтер может проверить, какая нейросеть точнее находит ошибки в таблицах, а школьник — какая понятнее объясняет математику.
Для теста я тоже выбрала рабочую задачу и решила проверить, как ChatGPT и Claude справляются с текстами. Новейших моделей в режиме Side by Side не оказалось, хотя в рейтинге они есть, поэтому я выбрала Claude Sonnet 5 и GPT-5.2 — обе с пометкой high.
Я пишу статьи для блога о CRM-маркетинге. Аудитория — маркетологи небольших интернет-магазинов, которые только начинают работать с рассылками. Тема статьи: как вернуть клиентов, которые давно ничего не покупали, с помощью реактивационной цепочки писем.
Предложи структуру статьи: заголовок, лид и 5—7 подзаголовков. Под каждым подзаголовком — одно предложение о том, что будет в разделе.
Напиши лид и раздел о том, из каких писем состоит цепочка. Объем — не больше 3 000 знаков.
Условия:
— пиши просто, без канцелярита и штампов вроде «в современном мире» и «не секрет, что»;
— объясняй термины, которые новичок может не знать;
— приведи пример цепочки для магазина детской одежды: сколько писем, когда их отправлять и что в каждом;
— не придумывай статистику: если приводишь цифры, укажи источники;
— учти требования российского закона к рекламным рассылкам.
Обе модели в целом справились с задачей: предложили структуру из семи разделов, расписали цепочку писем по дням и не стали выдумывать статистику. При этом ни одна не уложилась в объем: вместо трех тысяч знаков у Claude получилось около 4 300, у GPT — около 5 100.
GPT-5.2 выстроила структуру текста логичнее. Сначала она объяснила, как выбрать получателей рассылки, и только потом — что писать в каждом письме. Понравилось, что кроме подробного примера для магазина детской одежды она добавила варианты офферов в письма цепочки. Но, как обычно, ChatGPT поставила много слэшей, кавычек и уточнений в скобках. А еще не объяснила часть терминов — например, неопытный читатель может не знать, что такое «доставляемость писем».
Claude Sonnet 5 использовала меньше лишних знаков препинания, а в примере четко указала, при каких условиях уходит каждое следующее письмо. Понравилось, что в лиде модель сразу обозначила проблему, которую помогает решить текст. При этом включила в лид определение реактивационной цепочки, хотя в структуре оставила для этого отдельный блок. Получателей рассылки маркетологи выбирают до запуска, но Claude решила дать эту информацию только после раздела о письмах.
В итоге я пометила ответ Claude Sonnet 5 как лучший, но по факту оба варианта требуют доработки.
Agent Mode. В этом режиме модель выполняет масштабную задачу по шагам. Вы описываете результат, который хотите получить, а агент сам решает, что для этого нужно сделать: найти информацию в интернете, сравнить данные, оформить таблицу или нарисовать изображение. В этом режиме нельзя выбрать или узнать, какая модель работает над задачей, поэтому для сравнения он не подходит.
Для теста я попросила Agent Mode разобрать семейный бюджет и составила таблицу с нашими примерными расходами за месяц. Операции записаны так, как они выглядят в банковской выписке: дата, название получателя, сумма и кто платил. Категорий нет, разложить траты по ним — часть задачи агента.
Чтобы проверить, как агент работает с данными, я добавила в таблицу несколько деталей, которые он в теории может упустить:
- одна доставка из «Самоката» списана дважды (это я придумала, чтобы проверить, заметит ли агент подозрительную транзакцию);
- годовая подписка «Яндекс 360» оплачена в сентябре, ее нельзя считать ежемесячной тратой;
- корм для собаки куплен сразу на три месяца;
- крупные разовые покупки: две куртки, подарок родственникам, химчистка, поездка на такси.
Для работы с файлами агента можно связать с Google Docs или Notion, а можно загрузить файл в формате CSV, как сделала я. Запрос был такой:
«Это наши расходы за сентябрь 2026 года. Мы пара, живем в Москве в своей квартире, у нас две машины и собака. Разбей траты по категориям, посчитай сумму по каждой и построй диаграмму. Отдели разовые покупки и платежи, которые вносятся не каждый месяц, от регулярных расходов. Проверь, все ли там ок. Предложи, где можно сэкономить 10 000 ₽ в месяц, не отказываясь от пиццы по пятницам и занятий с кинологом. Итог сохрани в PDF».
Агент что-то гуглил, запускал команды и периодически напоминал себе, что нельзя трогать пиццу и кинолога. Время ответа зависит от модели: один агент может думать 20 минут, другой — пять. В результате я получила отчет с анализом семейного бюджета на семь страниц и краткую сводку в чате.
Часть задачи агент выполнил хорошо. Он нашел два одинаковых платежа в «Самокате» и предложил проверить, не списали ли деньги дважды. Понял, что корм для собаки куплен впрок, а «Яндекс 360» оплачен на год, поэтому не стал считать эти покупки ежемесячными. Пиццу по пятницам и кинолога сохранил.
Но ошибок тоже много. Налог для самозанятых агент назвал ежеквартальным, хотя его платят каждый месяц. Предложил экономить на кофе навынос, хотя в таблице таких расходов не было. Еще выдумал проценты по кэшбэку, ежемесячную подписку iCloud записал в разовые, а две поездки на такси в одну субботу — в регулярные.
Из-за этих ошибок неверны и итоговые цифры отчета. По расчетам агента, месяц без крупных покупок обходится нам в 108 тысяч рублей. Если вернуть в регулярные траты налог и подписку, а такси убрать, получится около 116 тысяч. План экономии тоже не сходится. Агент обещал сократить расходы на 14 000 ₽, но часть этой суммы — экономия на кофе и отказ от такси, которое и так было разовым. Без них план едва дотягивает до 10 000 ₽. Поэтому я отметила, что агент не выполнил задачу.
Я запускала этот запрос дважды, и отчеты различались: другие категории, другие выводы, другой план экономии. Но в обоих случаях были похожие ошибки: модели путали регулярные и разовые траты, додумывали детали, которых нет в выписке, и называли процент кэшбэка без источника. Такой результат никуда не годится.
Direct. Режим подходит, когда нужно просто решить задачу без сравнения нейросетей. По умолчанию в нем работает Max — собственный алгоритм Arena, который сам выбирает подходящую модель под каждый запрос. Max умеет искать информацию в интернете, генерировать и редактировать картинки, писать код для сайтов. Если нужна конкретная нейросеть, ее можно выбрать из списка вручную — например, чтобы попробовать модель до покупки подписки на ее официальном сайте.
Для теста я выбрала реальную задачу, с которой столкнулась недавно: надо было пойти на бал, но покупать новое платье не хотелось. Попросила Max придумать, как сделать из свадебного платья бальное, и прикрепила фото.
Меня пригласили на мероприятие с дресс-кодом «бал». Организаторы сказали, что можно прийти в свадебном платье, его фото во вложении. Что с ним сделать, чтобы оно не выглядело так свадебно, но вписывалось в тематику бала? Шить, кроить или как-то еще менять платье конструктивно я не хочу. Предложи 3—4 готовых образа: что добавить, какого цвета, чем заменить привычные свадебные детали
Перед отправкой запроса, я выбрала тип задачи Image и загрузила фото платья. Max передал запрос модели OpenAI, которая сгенерировала картинку. Платье получилось похожим на реальное, но спереди модель сделала его короче, чем на самом деле, а бант нарисовала сбоку, хотя в описании образа его завязывают сзади.


Как сравнивать ответы
Подробных инструкций по оценке ответов у Arena нет — сервис советует выбирать тот, что лучше решает задачу. Но «лучше» — понятие абстрактное, поэтому вот несколько советов, которые я сформулировала по итогам изучения платформы.
Сравнивать модели на нескольких запросах. Результат одной и той же модели меняется от промпта к промпту, поэтому один удачный ответ не означает, что она постоянно лучше справляется с задачей. Например, если нужна модель для иллюстраций к постам, стоит попросить ее сгенерировать несколько картинок на разные темы и в разных стилях. Это можно сделать в режиме Side by Side: модели не меняются, так что одной паре можно задать несколько запросов подряд. В Battle Mode так не получится, потому что после каждого голоса Arena подбирает новые модели.
Ставить измеримые требования. Тогда остается посчитать, какая модель учла больше важных пунктов. Например, для текста это могут быть объем, формат и аудитория. Для картинки — пропорции, цвета и кадр. Для кода — на каком языке писать, какие данные вводит пользователь и что должен получить на выходе.
Оценивать по содержанию. Исследователи Arena выяснили, что на голоса влияет оформление: длинные ответы с заголовками и списками нравятся людям больше, даже если по сути они не лучше коротких. Поэтому в рейтинге есть переключатель Style Control, который убирает влияние оформления на оценку. С картинками и видео похожая ловушка: яркое детализированное изображение может на первый взгляд показаться отличным, даже если модель проигнорировала половину запроса. Поэтому сначала проверяйте, выполнена ли задача, и только потом оценивайте, как выглядит результат.
Смотреть, учла ли модель ваши данные. Если в запросе есть фото, файл или описание ситуации, хороший ответ должен на них опираться. Например, в ответе на вопрос о ремонте модель должна учесть указанную площадь комнаты, а при редактировании фото — сохранить лицо, предмет или интерьер.
Проверять факты и детали. Модели в Arena ошибаются. Если в ответе есть источник данных, откройте его, а важные факты без источника проверьте. Еще модели могут вставлять советы, о которых вы не просили, — цены, проценты, рекомендации без источника. Их тоже стоит проверять, потому что они могут быть ложными.
Что в итоге
- Arena — бесплатная платформа, где можно отправить один запрос нейросетям разных компаний и сравнить ответы. Из голосов пользователей складывается публичный рейтинг. Он более репрезентативен, чем стандартные тесты: модели оценивают люди, исходя из ответов на свои запросы.
- Сервис работает в России и дает доступ к моделям, которые в стране недоступны, например к Gemini. Официального приложения у Arena нет, только сайт. Количество запросов ограничено дневным лимитом, а снять его за деньги нельзя. Переписка может попасть в открытые датасеты, поэтому личные данные в запросы лучше не добавлять.
- Рейтинги показывают, какие модели чаще нравятся пользователям, но выбирать стоит по подкатегории, близкой к своей задаче: лидеры в них различаются. Если разница в баллах небольшая, модели почти равны.
- Режим работы лучше выбирать по цели. Battle Mode подходит, чтобы сравнить модели вслепую. Side by Side — чтобы выбрать из двух конкретных нейросетей, правда, новых версий там может не быть. Direct — чтобы обратиться к одной модели без сравнения. Agent Mode — для многошаговых задач, но модель там выбирается случайно и результат стоит воспринимать как черновик.
- Ни одна модель в тестах не справилась идеально. Нейросети ошибались в фактах и расчетах, не учитывали деталей запросов.
- Чтобы сравнение было полезным, лучше давать моделям несколько типичных запросов с измеримыми требованиями, оценивать содержание ответов, проверять факты и смотреть, учла ли модель ваши данные.
Мы постим кружочки, красивые карточки и новости о технологиях и поп-культуре в нашем телеграм-канале. Подписывайтесь, там классно: @t_technocult